

私的AI研究会 > ComfyUI21
「ComfyUI」を使ってローカル環境でのAI画像生成を検証する
| 2026年10月16日、中国復旦大学発の OpenMOS Sチームが公開した FLUX.3 MOSS-Image を検証してみる |
| このプロジェクトで作成するワークフローと関連データは下記にアップロードしている(更新されている場合は再度ダウンロードのこと) |
📂ComfyUI
  └─📂user
        └─📂default
              └─📂workflows        ← ワークフローの保存場所
                    :
                    ├─📂MOSS-Image     ← この章で作成するワークフロー
                    :
・解凍してできる「ComfyUI/」フォルダを「StabilityMatrix/Data/Packages/ComfyUI」へ上書きコピーする| 拡張ノード(検索名) | 拡張ノード URL | 主な機能 / 参照ページ | ワークフロー |
| rgthree | rgthree-comfy | ノードをスイッチで切り替える | |
| ComfyUI_Custom_Nodes_AlekPet | ComfyUI_Custom_Nodes_AlekPet | プロンプトを日本語入力する |
| モデル名 | ファイル名(.safetensors) | 配置先(/StabilityMatrix/Data/) | ダウンロード URL | サイズ | |
| diffusion_models | moss_image_base_int8_convrot | Models/ | DiffusionModels/ | moss_image_base_int8_convrot.safetensors | 5.41GB |
| moss_image_sft_int8_convrot (蒸留版) | moss_image_sft_int8_convrot.safetensors | 5.41GB | |||
| text_encoders | qwen3.5_9b_w4a8_gptq | TextEncoders/ | qwen3.5_9b_w4a8_gptq.safetensors | 7.34GB | |
| vae | flux2-vae | VAE/ | flux2-vae.safetensors | 0.56GB | |
| flux2-vae_small | flux2-vae_small.safetensors | 0.25GB | |||
| LoRA | lora_latest | Lora/ | lora_latest.safetensors | 1.19GB | |
| フォルダ | ワークフロー名 (.json) | モデル | 機能 (参照ページ) | 特記事項(同じ機能のワークフロー .json) |
| MOSS-Image | 8600_moss_image_8step_t2i | INT8 ConvRot | Text to Image (8Step) 基本ワークフロー | (image_moss_image_t2i.json) + 8Step LoRA |
| 8601_moss_image_t2i | Text to Image 基本ワークフロー | (image_moss_image_t2i.json) |
| ComfyUI オフィシャルサイトで公開されているテンプレートのシード値を固定して再現性を確保し動かしながら整理する |
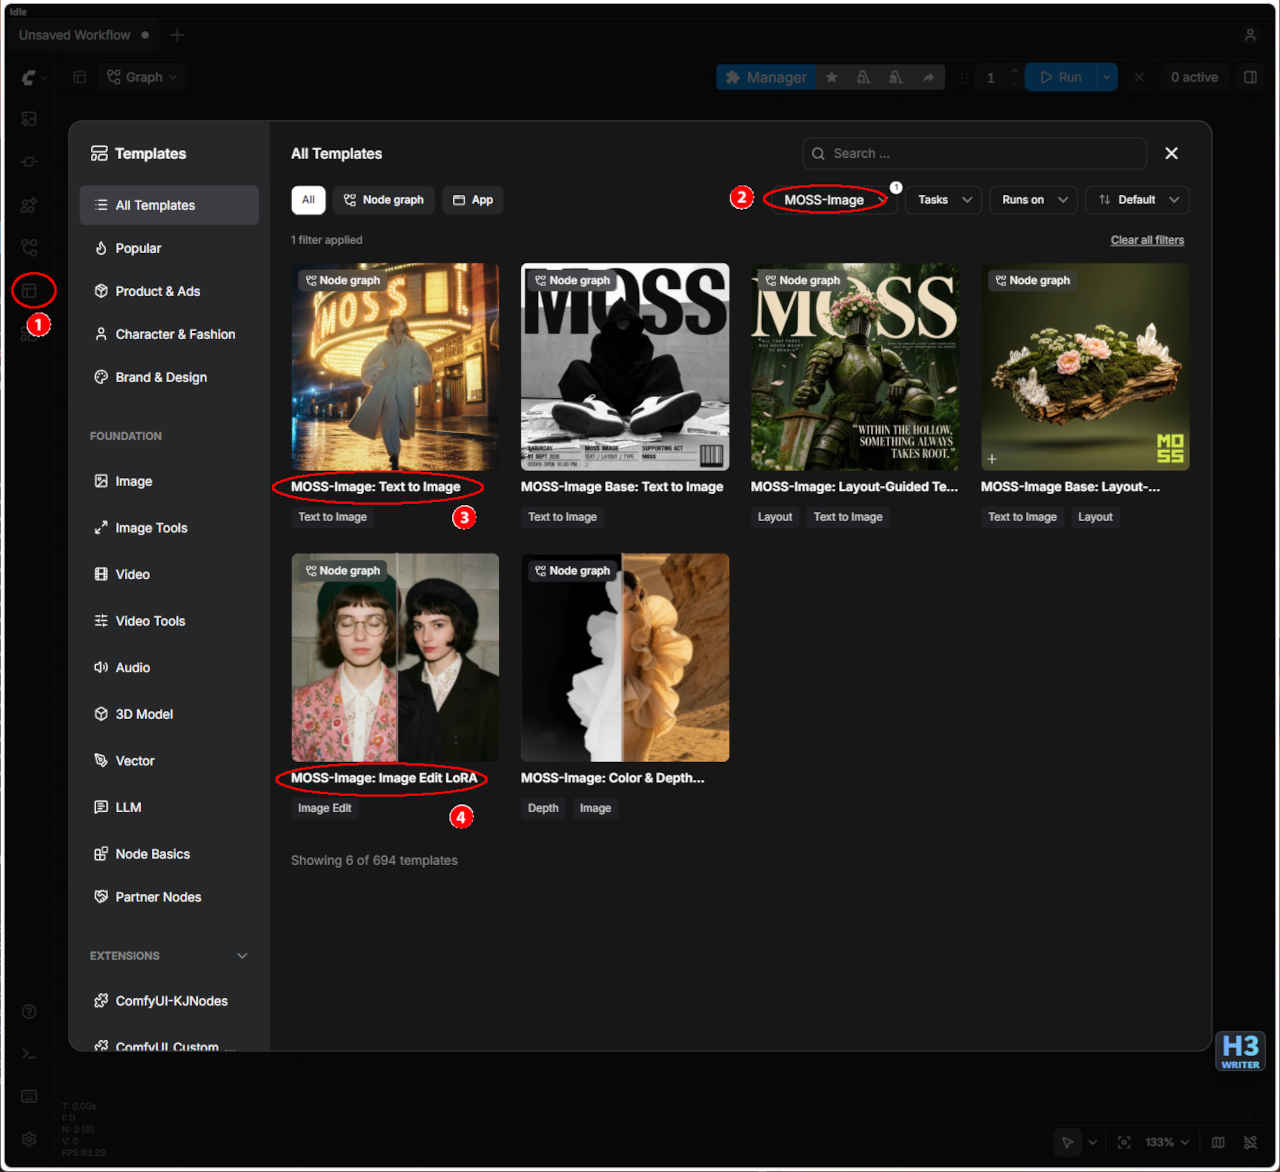 | ① 左端のメニューから「Template」を選択 ②「MOSS-Image」を入力する ・表示された一覧からワークフローを選ぶ ③「image_flux3_klein_t2i: Text to Image」 ・ワークフローでエラーが発生する場合はモデルの配置を確認する |
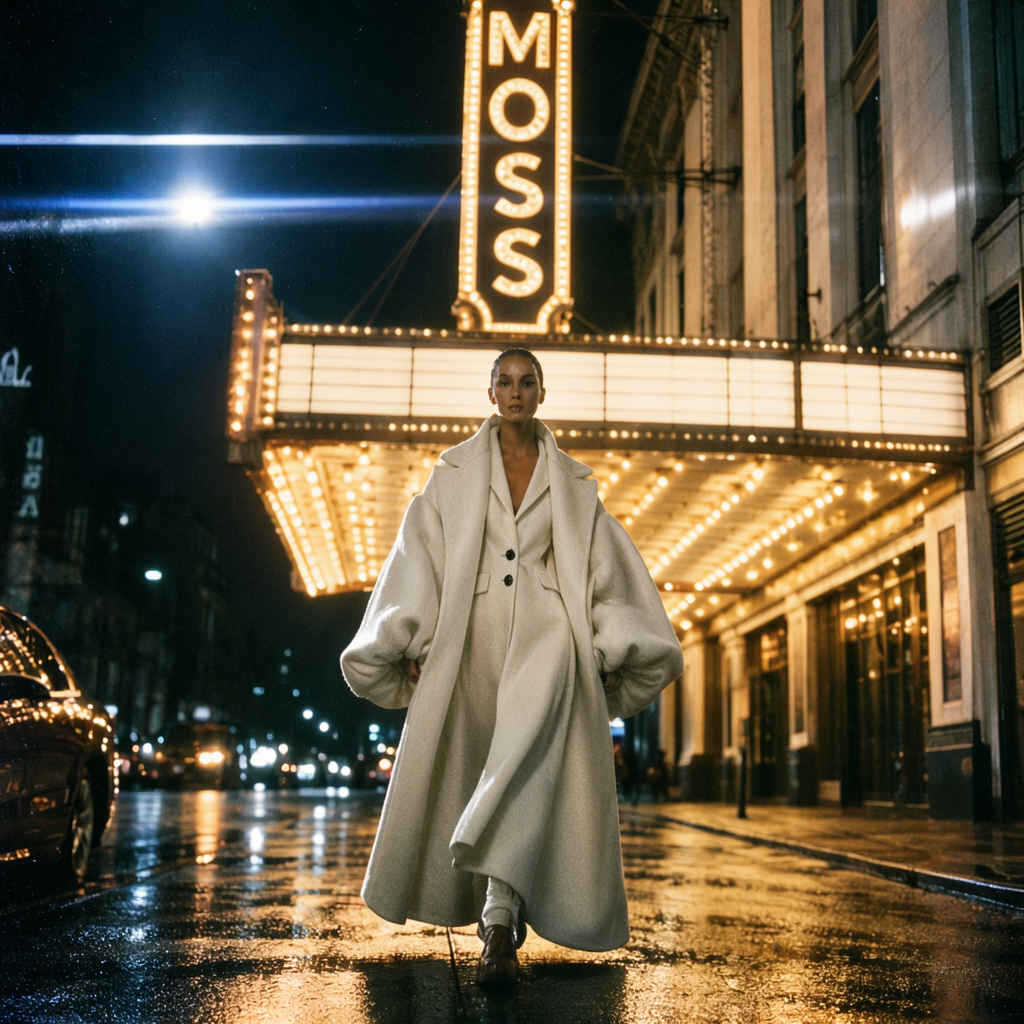
| Text to Image 生成画像 | |
| |
| プロンプト |
| A cinematic night street photograph captures a model walking directly toward the camera, wearing an exaggerated white wool coat with voluminous balloon sleeves. The scene is set beneath a massive illuminated theatre marquee where tall capital letters spell "MOSS" in a glowing sequence, dominating the upper center of the frame. The composition utilizes a low angle to emphasize the height of the sign and the imposing presence of the figure. Wet asphalt covers the ground, creating long, shimmering reflections of the marquee lights that stretch toward the viewer. Warm tungsten light from the bulbs contrasts sharply with the cold blue tones of the surrounding night sky. Anamorphic lens flares streak across the upper left quadrant, adding a cinematic quality to the atmosphere. The image features distinct 35mm film grain, lending a textured, nostalgic feel to the urban environment. |
| 映画のワンシーンを思わせる夜のストリート写真。ボリューム感のあるバルーンスリーブが特徴的な、大ぶりの白いウールコートをまとったモデルが、カメラに向かってまっすぐに歩いてくる。背景には、巨大な劇場用マーキー(看板)が掲げられ、そこには「MOSS」という大きな文字が光を放ちながら、画面上部中央で圧倒的な存在感を放っている。ローアングルからの構図が、看板の高さとモデルの堂々たる佇まいを強調する。濡れたアスファルトの路面には、マーキーの光が長く、きらめきながら映り込み、見る者の方へと伸びている。電球から放たれる温かみのあるタングステン光が、周囲の夜空の冷たい青色と鮮やかなコントラストを描き出す。画面左上にはアナモルフィック・レンズ特有のフレアが走り、映画的な雰囲気を一層際立たせている。全体には35mmフィルム特有の粒子感が漂い、都会の風景に質感とノスタルジックな情緒を与えている。 |
| MOSS-Image Text toImage ワークフロー | MOSS-Image Text to Image SubGraph |
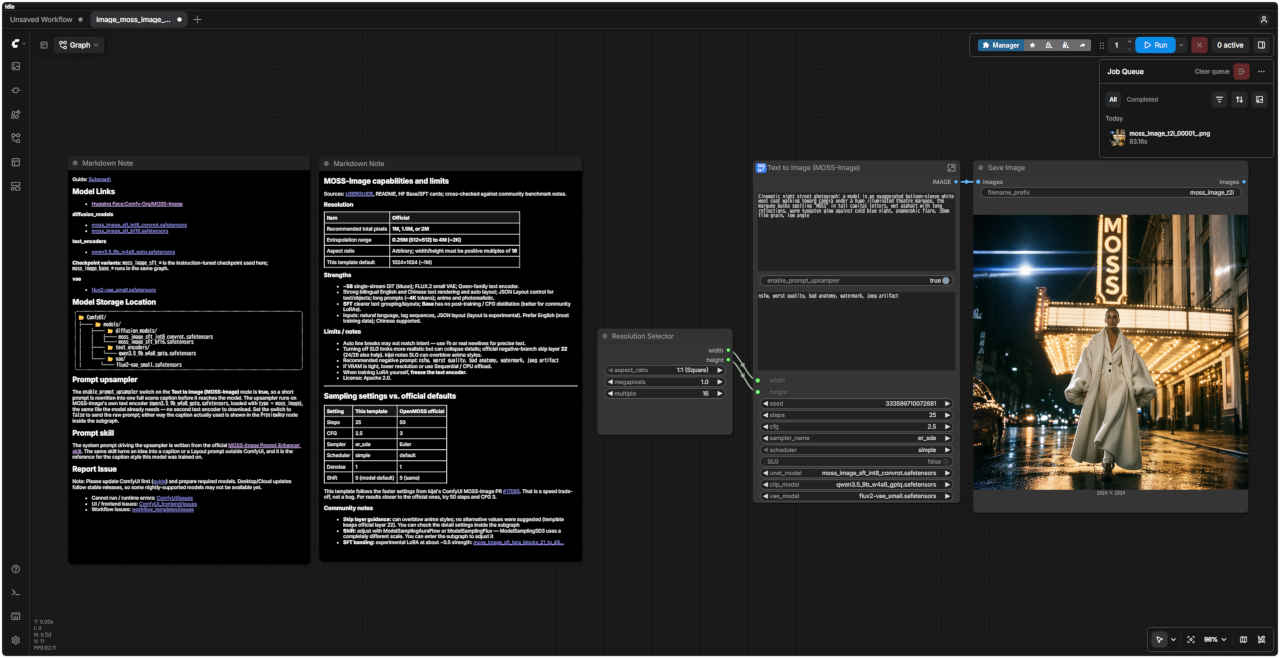 | 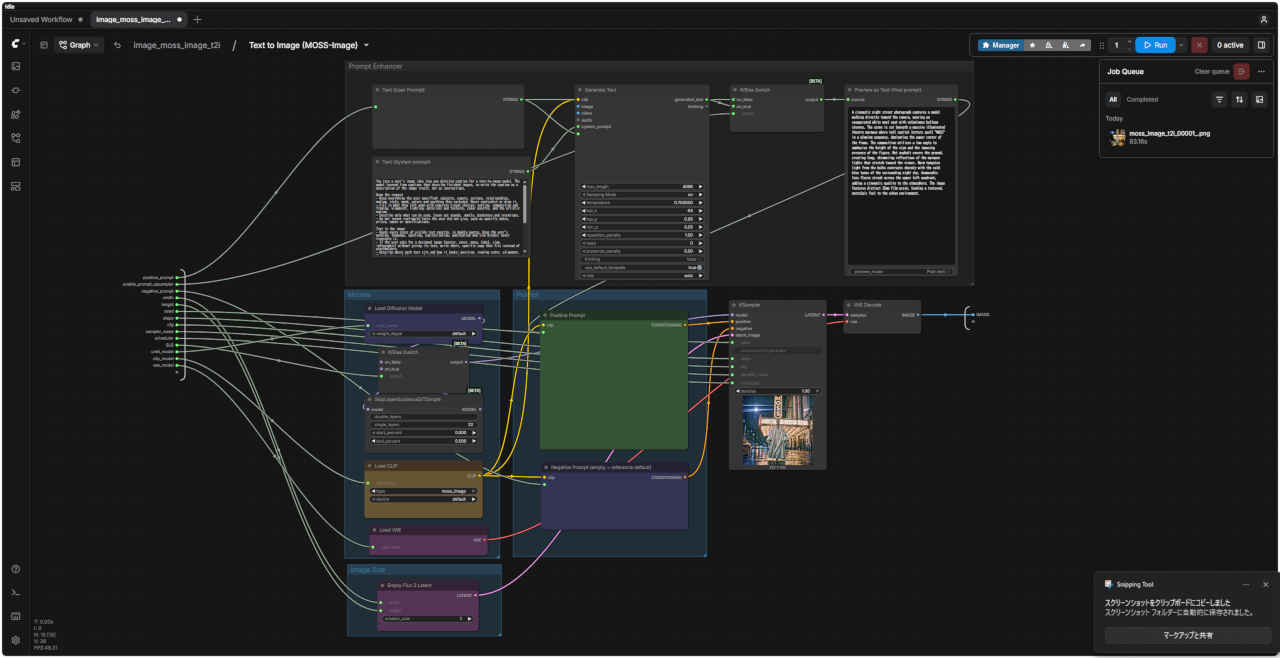 |
| 「MOSS-Image/」image_moss_image_t2i.json | |
| Prompt upsampler(プロンプト・アップサンプラー) |
| Text to Image (MOSS-Image) ノードにある `enable_prompt_upsampler` スイッチが `true` に設定されている場合、入力された短いプロンプトは、モデルに渡される前に、シーン全体を詳細に記述したキャプションへと書き換えられます。このアップサンプラーは、MOSS-Image 自身が使用するテキストエンコーダー(`qwen3.5_9b_w4a8_gptq.safetensors`、読み込み設定 `type = moss_image`)を利用して動作します。モデルの実行に必須のファイルがそのまま使われるため、追加で別のテキストエンコーダーをダウンロードする必要はありません。スイッチを `false` に設定すれば、元のプロンプトをそのまま送信することも可能です。いずれの場合も、実際に使用されたキャプションは、サブグラフ内の `PreviewAny` ノードで確認できます。 |
| Prompt skill (プロンプト・スキル) |
| アップサンプラーを制御するシステムプロンプトは、公式の MOSS-Image Prompt Enhancer スキル に基づいて作成されています。このスキルは、ComfyUI の外部環境において、アイデアをキャプションやレイアウト・プロンプトへと変換する役割を担うものであり、本モデルの学習時に用いられたキャプション・スタイルの基準となっています。 |
| Resolution(解像度) | サンプリング設定と公式デフォルトの比較 | ||||
| 項目 | 公式仕様 | 設定項目 | 本テンプレート | OpenMOSS 公式 | |
| 推奨総画素数 | 1M、1.5M、または 2M | Steps | 25 | 50 | |
| 対応範囲 | 0.25M (512×512) ~ 4M (~2K) | CFG | 2.5 | 3 | |
| アスペクト比 | 任意(幅・高さは 16 の正の倍数であること) | Sampler | er_sde | Euler | |
| 本テンプレートのデフォルト | 1024×1024 (~1M) | Scheduler | simple | default | |
| 本テンプレートは、kijai氏によるComfyUI MOSS-Imageのプルリクエスト #17095 で提案された、より高速な設定に基づいています。これは処理速度を優先した結果であり、バグではありません。公式に近い結果を得たい場合は、Stepsを50、CFGを3に設定してみてください | Denoise | 1 | 1 | ||
| Shift | 5 (モデルデフォルト) | 5 (同上) | |||
| Strengths(強み) |
| 約 5B パラメータのシングルストリームDiT(Muonアーキテクチャ)、FLUX.2の小型VAE、Qwenシリーズのテキストエンコーダーを採用 |
| 英語・中国語のバイリンガル対応。テキストの描画や自動レイアウトに優れ、JSON形式によるテキストやオブジェクトの配置制御が可能。長文プロンプト(約 4Kトークン)に対応し、アニメ調から写実的な表現まで幅広くカバー |
| SFT 版 はテキストのグループ化やレイアウトがより明確。Base 版 は追加学習(ポストトレーニング)やCFG蒸留が行われていないため、コミュニティ製のLoRA学習に適している |
| 入力形式:自然言語、タグ列、JSONレイアウト(レイアウト機能は実験的)。学習データの大部分が英語であるため英語での入力が推奨されるが、中国語にも対応 |
| Limits / notes(制限事項・注意点) |
| 自動改行が意図通りにならない場合がある。正確なテキスト配置が必要な場合は、`\n`または実際の改行コードを使用すること |
| SLG(Skip Layer Guidance)を無効にすると写実性は高まるが、細部が崩れる可能性がある。公式推奨のネガティブブランチ・スキップレイヤーは 22(24 や 26 も有効)。なお、kijai氏の指摘によると、SLGを使用するとアニメ調のスタイルで色が飛びすぎる(過度に強調される)場合がある |
| 推奨ネガティブプロンプト:`nsfw, worst quality, bad anatomy, watermark, jpeg artifact` |
| VRAMが不足する場合は、解像度を下げるか、Sequential(逐次処理)またはCPUオフロードを使用すること |
| LoRAを学習させる際は、テキストエンコーダーをフリーズ(固定)すること |
| ライセンス:Apache 2.0 |
| コミュニティからの注意点 |
| Skip layer guidance: アニメ調のスタイルでは、適用しすぎると画が破綻(オーバーブロウ)する可能性があります。代替となる推奨値は提示されていないため、本テンプレートでは公式設定の「レイヤー22」を維持しています。詳細な設定はサブグラフ内で確認可能です |
| Shift: `ModelSamplingAuraFlow` または `ModelSamplingFlux` を使用して調整してください(`ModelSamplingSD3` はスケールが全く異なるため使用できません)。サブグラフ内に入って調整を行うことができます |
| SFT banding: 実験的な LoRA(適用強度:約 0.5): moss_image_sft_lora_blocks_21_to_49… |
| プロンプト | 8601 MOSS-Image Text to Image ワークフロー |
|
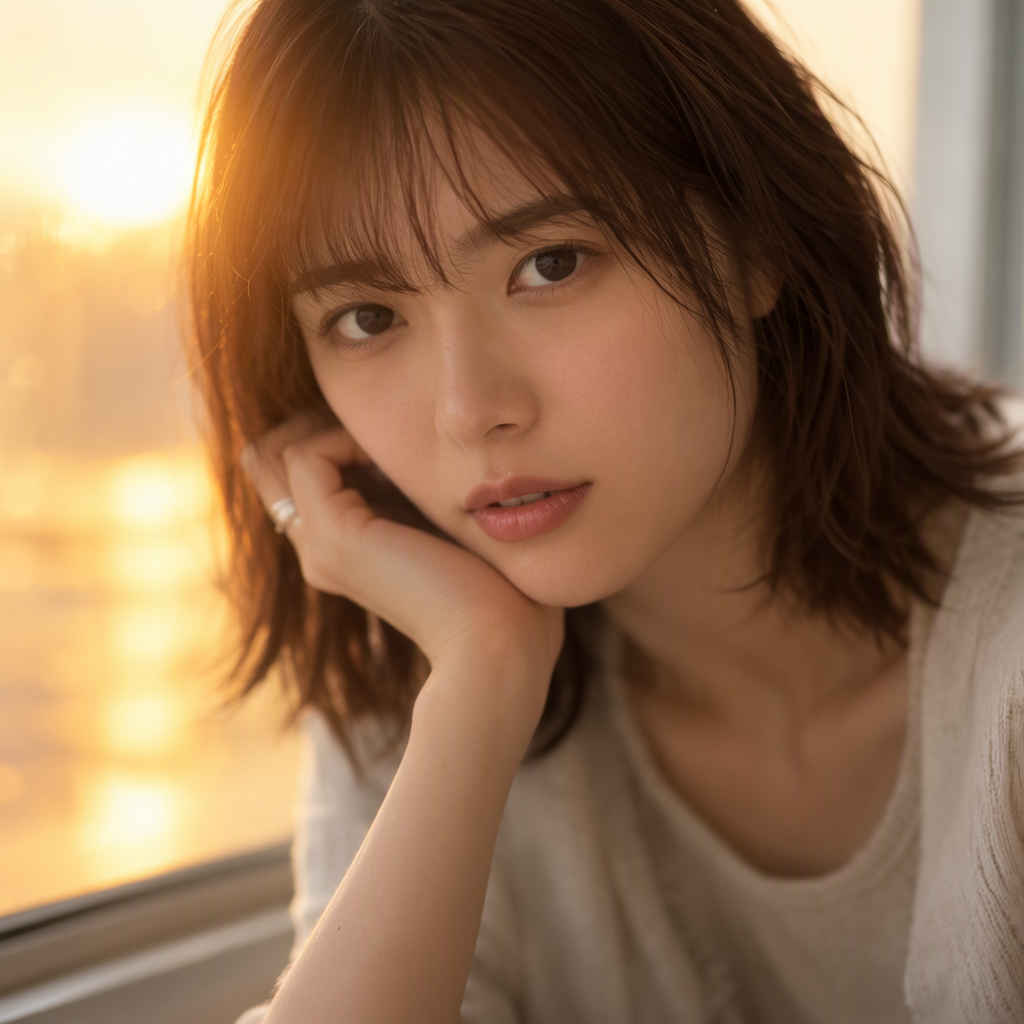
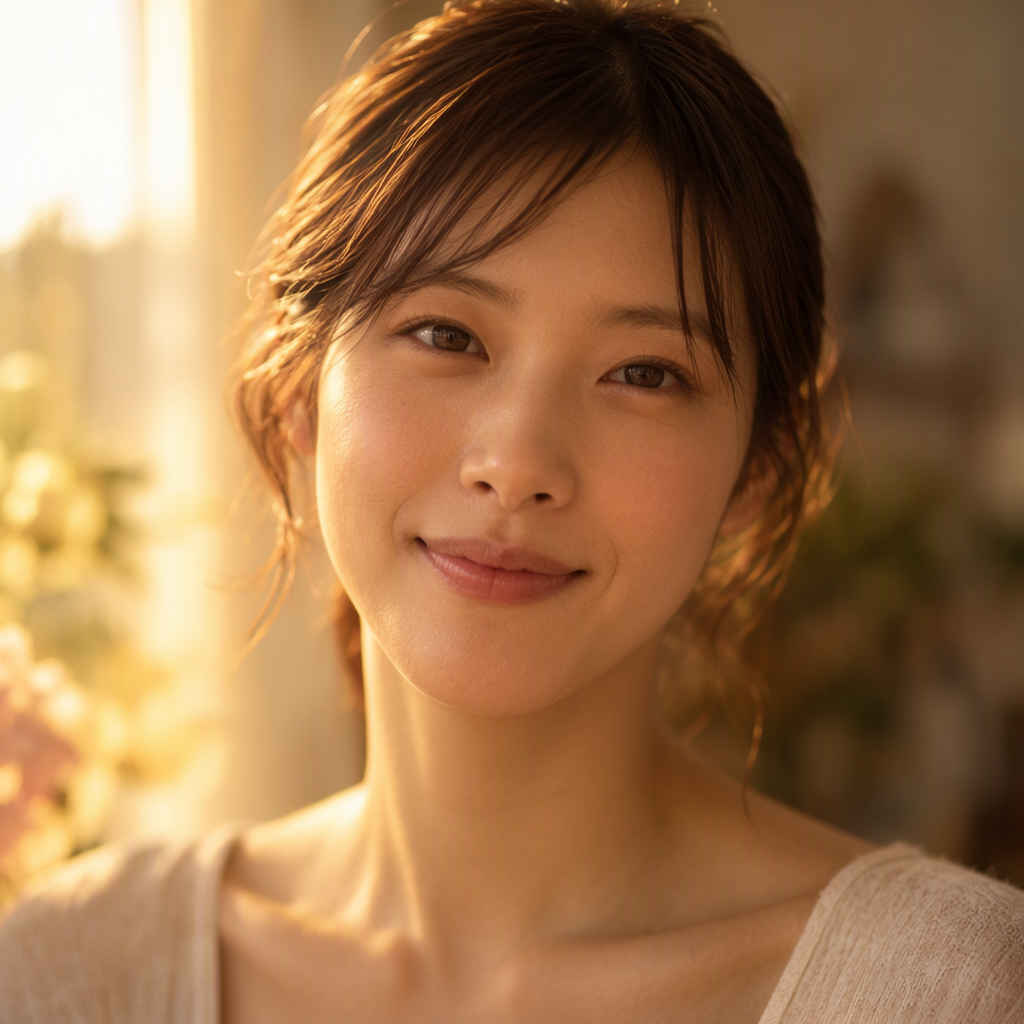
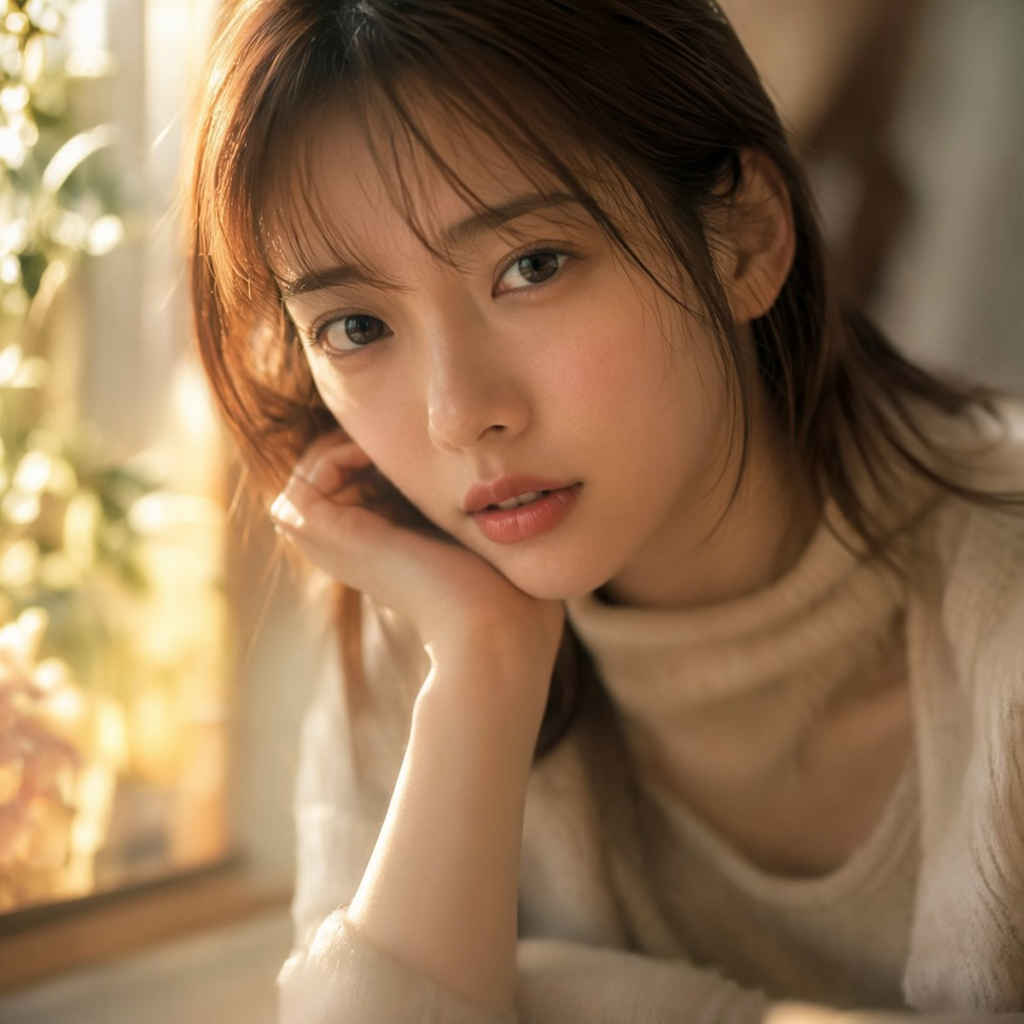
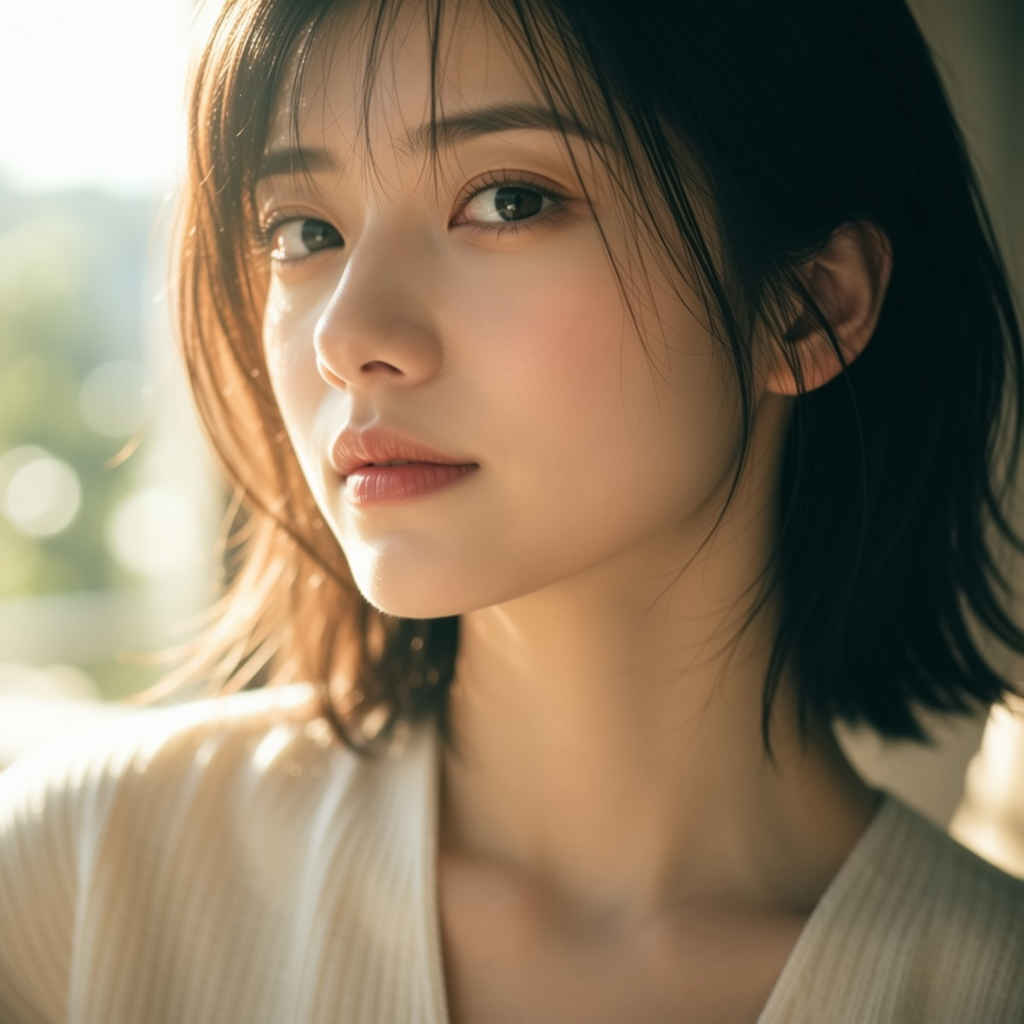
Close-up portrait of a young japanease woman in her 20s, natural makeup, soft expression. 85mm lens, f/1.4, shallow depth of field, bokeh background. Soft window light from the left, golden hour glow, warm skin tones. Cinematic, realistic, high detail, professional photography. NOT: oversaturated, anime style, low resolution, distorted face. | 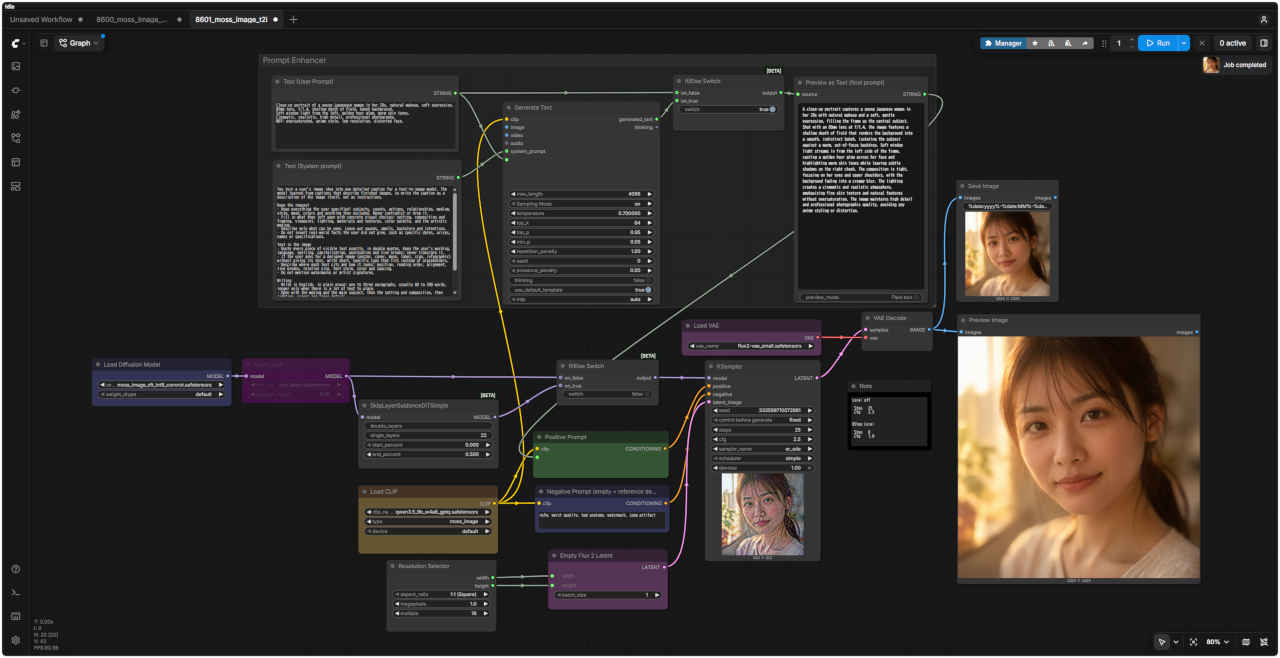 「MOSS-Image/」8601_moss_image_t2i.json |
|
20代の日本人女性のクローズアップ・ポートレート。ナチュラルメイク、柔らかな表情。 85mmレンズ、f/1.4、浅い被写界深度、背景のボケ。 左側からの柔らかな窓の光、ゴールデンアワーの輝き、温かみのある肌のトーン。 映画のような質感、写実的、高精細、プロフェッショナルな写真。 避けるべき要素:彩度過多、アニメ調、低解像度、顔の歪み。 |
| 日本語・エンハンサーなし | 日本語・エンハンサーあり | 英語・エンハンサーなし | 英語・エンハンサーあり |
 |  |  | 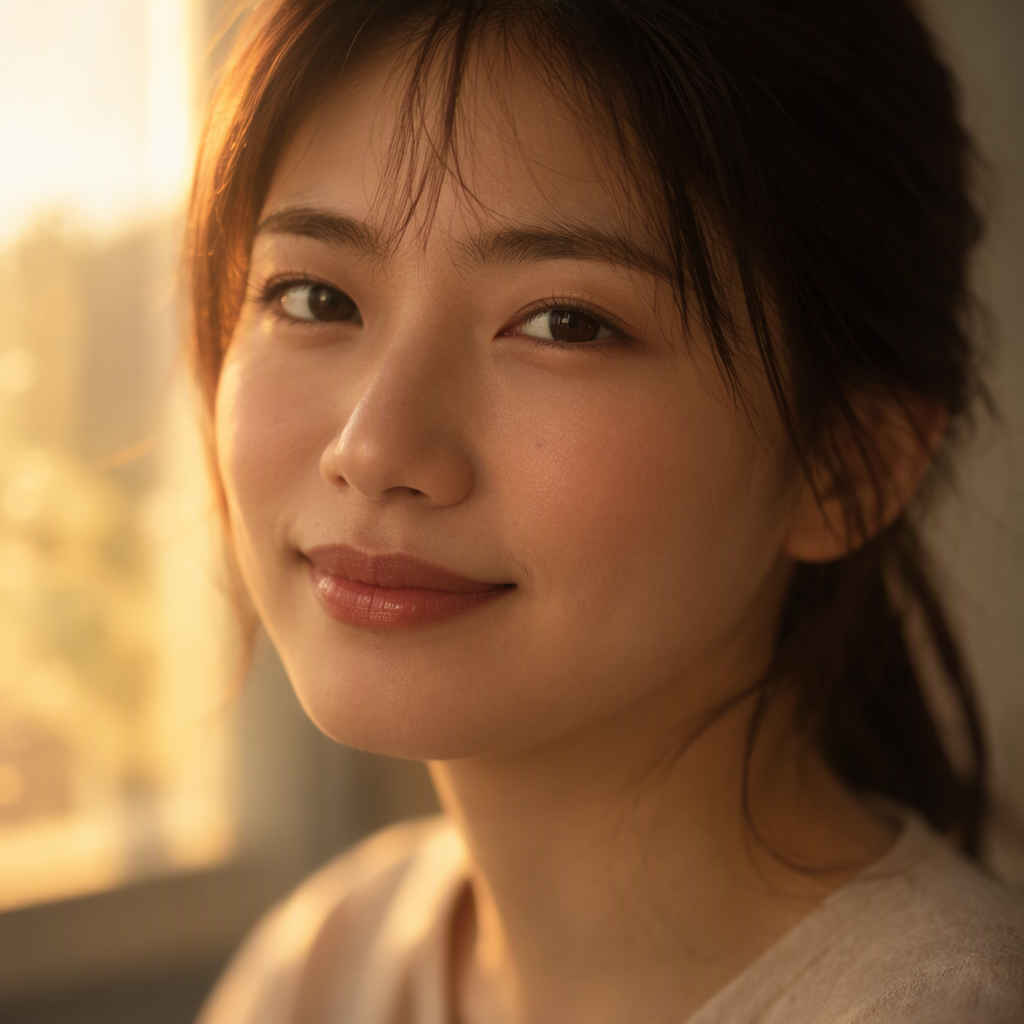 |
| プロンプト | 8600 MOSS-Image (8Step) Text to Image ワークフロー |
|
Close-up portrait of a young japanease woman in her 20s, natural makeup, soft expression. 85mm lens, f/1.4, shallow depth of field, bokeh background. Soft window light from the left, golden hour glow, warm skin tones. Cinematic, realistic, high detail, professional photography. NOT: oversaturated, anime style, low resolution, distorted face. | 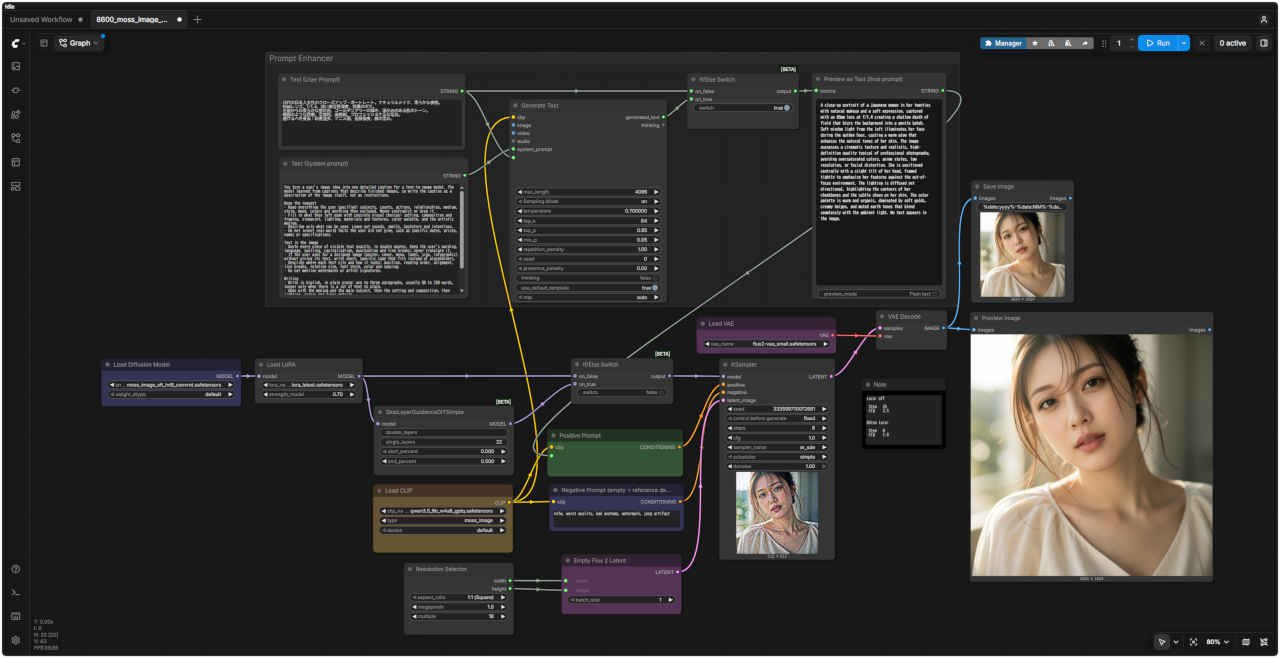 「MOSS-Image/」8600_moss_image_8step_t2i.json |
|
20代の日本人女性のクローズアップ・ポートレート。ナチュラルメイク、柔らかな表情。 85mmレンズ、f/1.4、浅い被写界深度、背景のボケ。 左側からの柔らかな窓の光、ゴールデンアワーの輝き、温かみのある肌のトーン。 映画のような質感、写実的、高精細、プロフェッショナルな写真。 避けるべき要素:彩度過多、アニメ調、低解像度、顔の歪み。 |
| 日本語・エンハンサーなし | 日本語・エンハンサーあり | 英語・エンハンサーなし | 英語・エンハンサーあり |
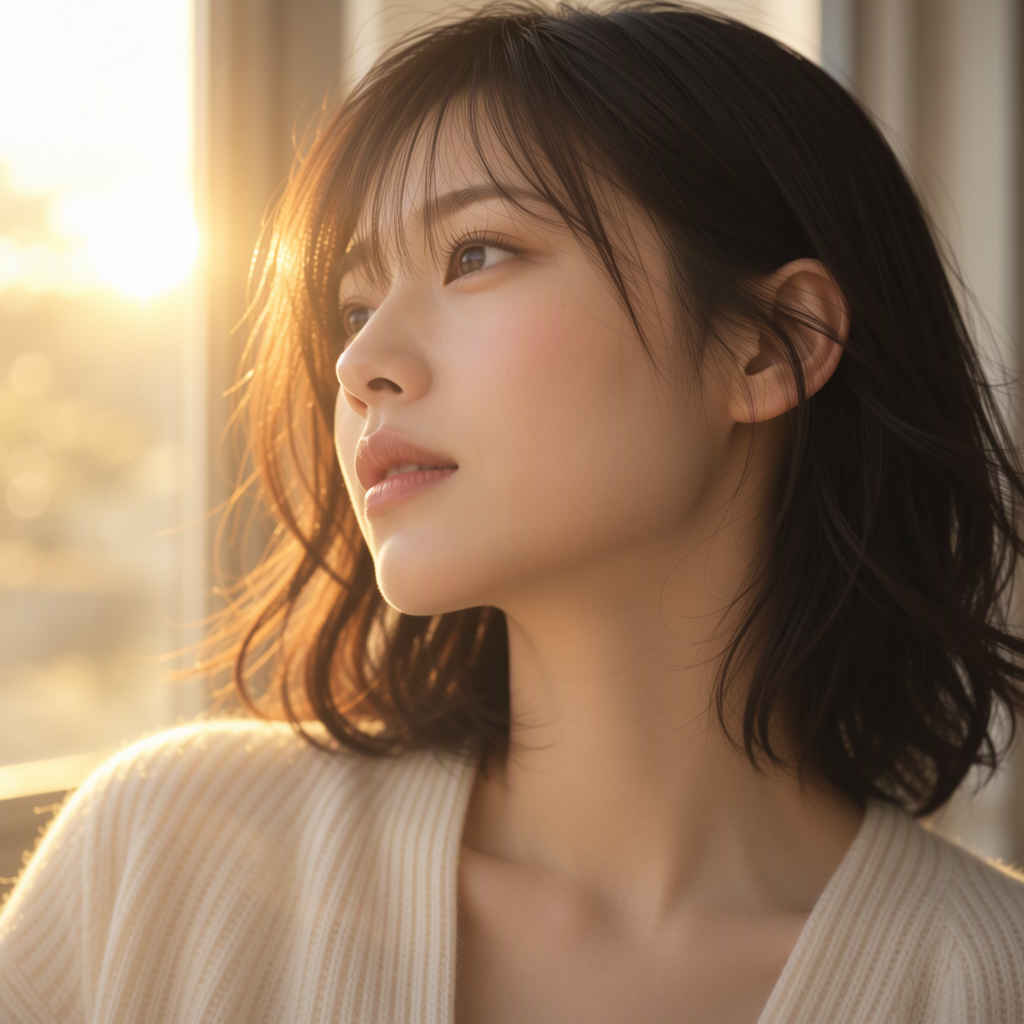 | 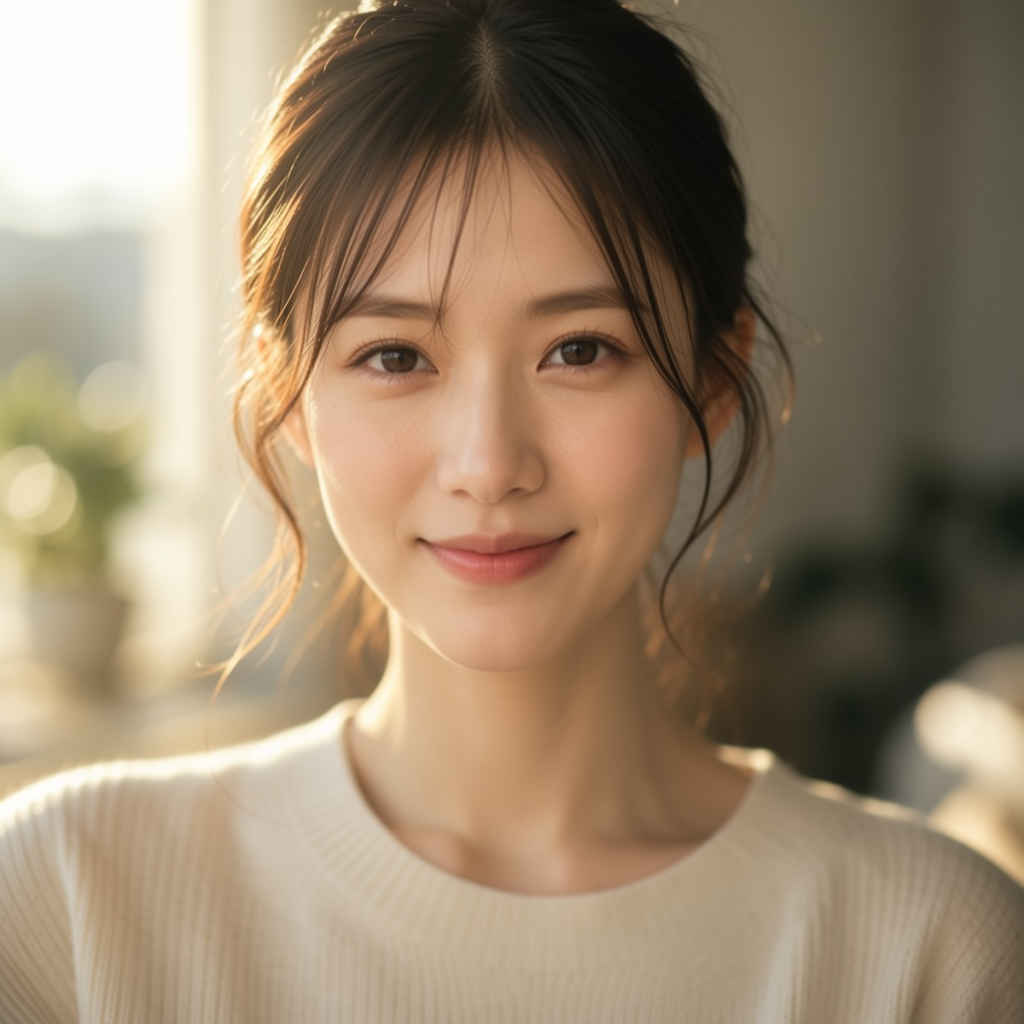 |  | 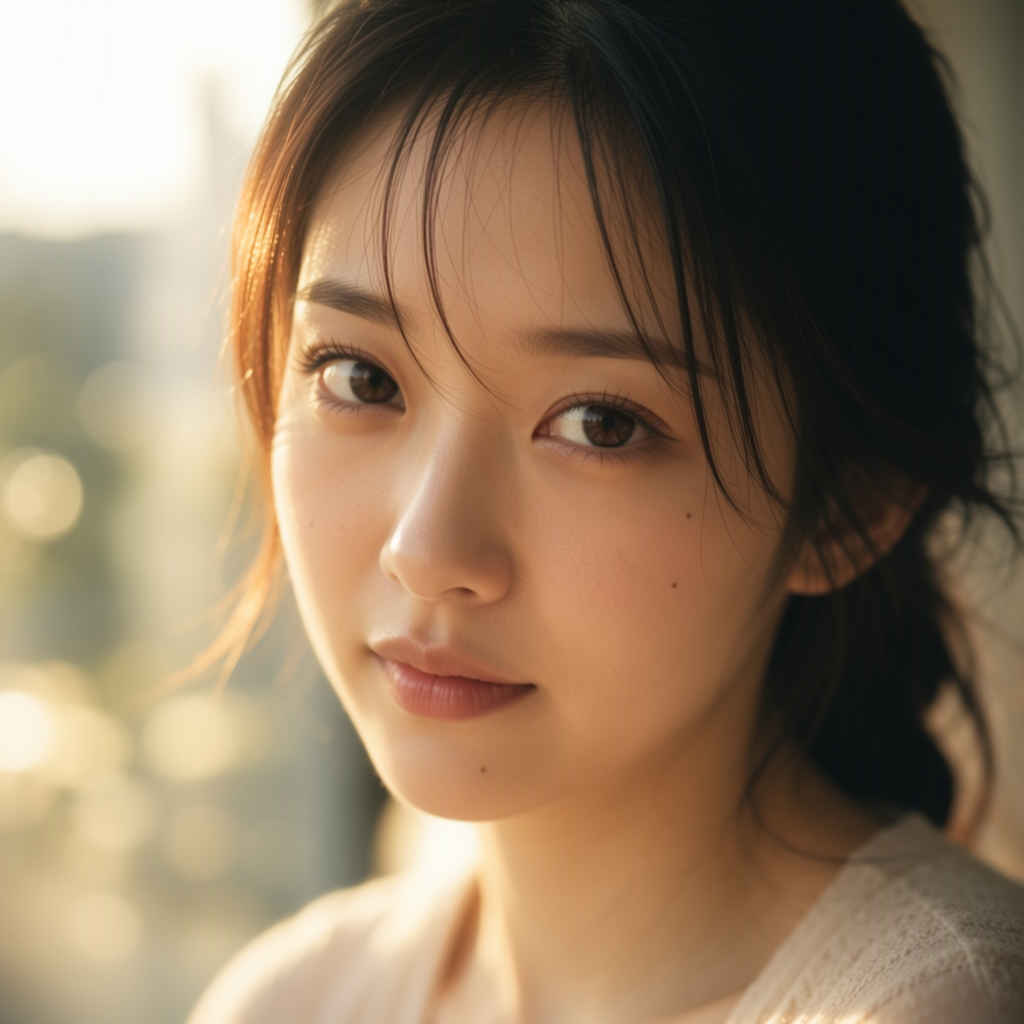 |