私的AI研究会 > ComfyUI9j
「ComfyUI」を使ってローカル環境でのAI画像生成を検証する
| 「MiniMax H3」を追加学習した高速化・高機能版の動画生成モデル「Pika H3 Flex」を検証する |
| このプロジェクトで作成するワークフローと関連データは下記にアップロードしている(更新されている場合は再度ダウンロードのこと) |
📂ComfyUI
  └─📂user
        └─📂default
              └─📂workflows        ← ワークフローの保存場所
                    :
                    ├─📂MiniMax       ← この章で作成するワークフロー
                    :
・解凍してできる「ComfyUI/」フォルダを「StabilityMatrix/Data/Packages/ComfyUI」へ上書きコピーする| ワークフロー | 機 能 | モデル | CPU | CPU | |||||
| RTX 4070 | RTX 4060 | RTX 4060L | RTX 3050 | GTX 1050 | i7-1260P | i7-1185G7 | |||
| 5631_pika_h3_t2v | Text to Video 基本ワークフロー | INT8 ConvRot | 11:40.80 | 22:17.12 | 非対応 | ||||
| 5632_pika_h3_i2v | Image to Video 基本ワークフロー | 03:59.33 | 06:37.93 | ||||||
| 5633_pika_h3_i2v | Image to Video 基本ワークフロー | 03:55.46 | 07:02.23 | ||||||
| 5634_pika_h3_r2v | Reference to Video 基本フロー | 10:26.16 | 31:41.60 | ||||||
| 拡張ノード(検索名) | 拡張ノード URL | 主な機能 / 参照ページ | 特記事項 |
| rgthree | rgthree-comfy | ノードをスイッチで切り替える | すべてのノードに必須 |
| ComfyUI_Custom_Nodes_AlekPet | ComfyUI_Custom_Nodes_AlekPet | プロンプトを日本語入力する |
| モデル名 | ファイル名(.safetensors) | 配置先(/StabilityMatrix/Data/) | ダウンロード URL | サイズ | |
| LoRA | pika_h3_flex_fl2va_v1_bf16 | Models/ | Lora/ | pika_h3_flex_fl2va_v1_bf16.safetensors | 1.96GB |
| pika_h3_flex_ref2va_v1_bf16 | pika_h3_flex_ref2va_v1_bf16.safetensors | 1.96GB | |||
| フォルダ | ワークフロー名 (.json) | モデル | 機能 (参照ページ) | 特記事項(同じ機能のワークフロー .json) |
| MiniMax | 5631_pika_h3_t2v | INT8 ConvRot | Text to Video 基本ワークフロー | (pika_h3_t2v.json) |
| 5632_pika_h3_i2v | Image to Video 基本ワークフロー | (pika_h3_i2v.json) | ||
| 5633_pika_h3_i2v | Image to Video 基本ワークフロー | (pika_h3_i2v.json) | ||
| 5634_pika_h3_r2v | Reference to Video 基本ワークフロー | (pika_h3_r2v.json) |
| ComfyUI オフィシャルサイトで公開されているテンプレートの動作を確認する |
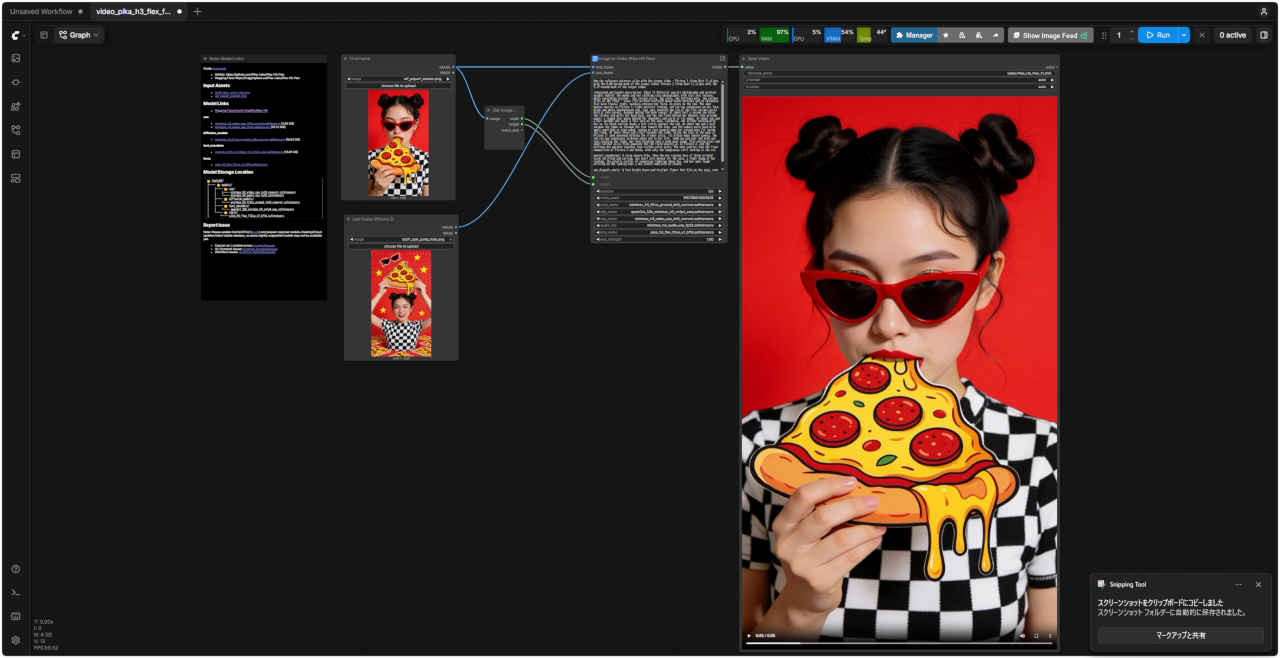
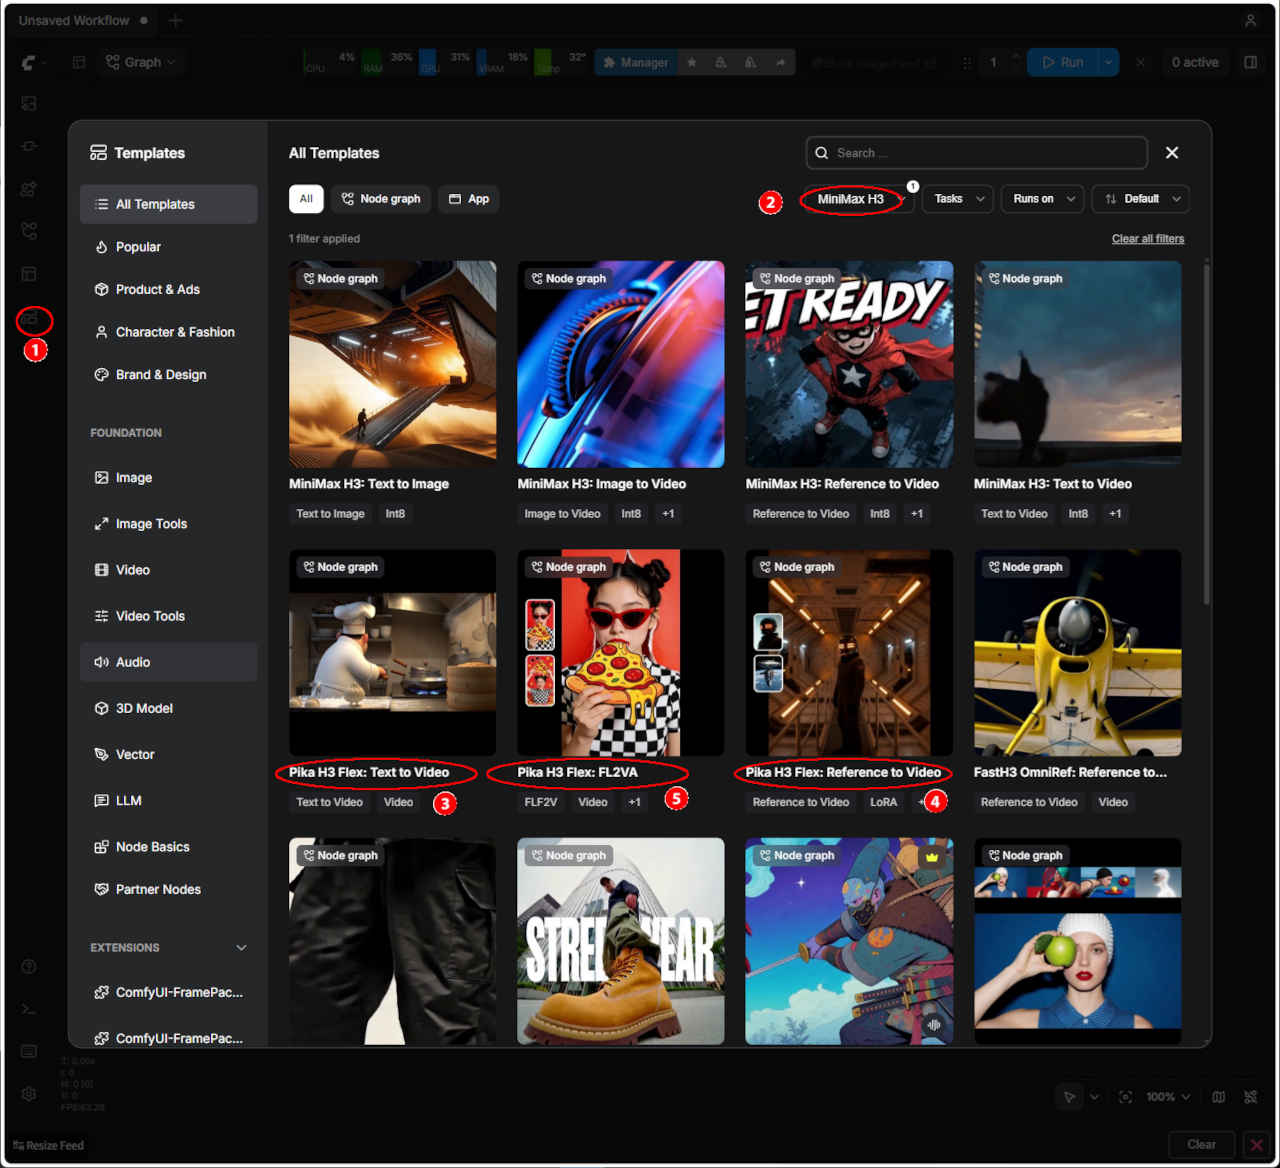 | ① 左端のメニューから「Template」を選択 ②「MiniMax H3」を選択する ・表示された一覧からワークフローを選ぶ ③「Pika H3 Flex: Text to Video」 ④「Pika H3 Flex: FL2VA」 ⑤「Pika H3 Flex: Reference to Video」 ・ワークフローでエラーが発生する場合はモデルの配置を確認する | |
| テンプレート名 | 保存ワークフロー名 | |
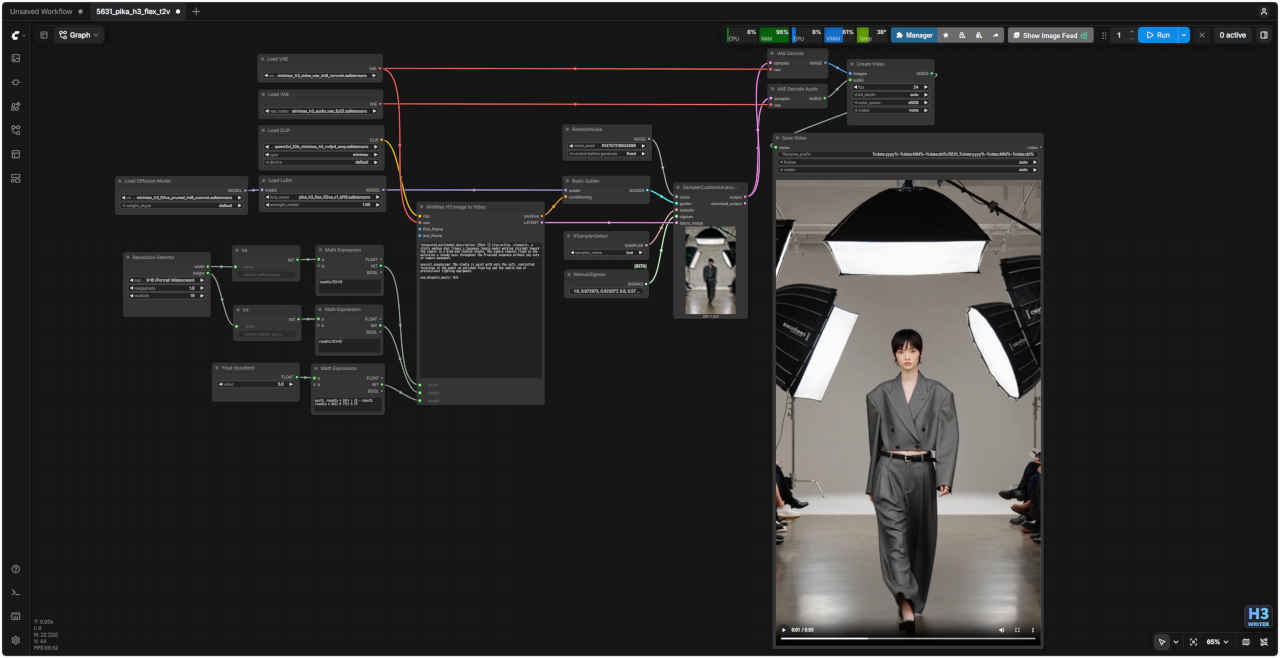
| ③ Pika H3 Flex: Text to Video | video_pika_h3_flex_t2v.json | |
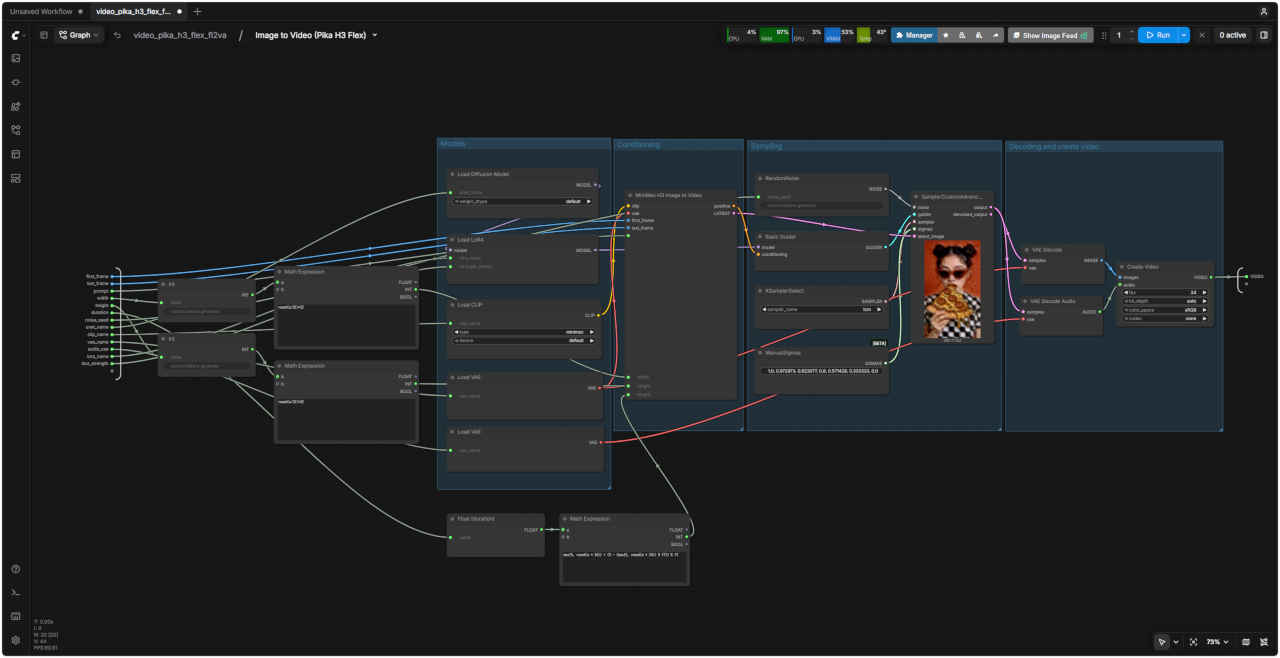
| ④ Pika H3 Flex: FL2VA | video_pika_h3_i2v.json | |
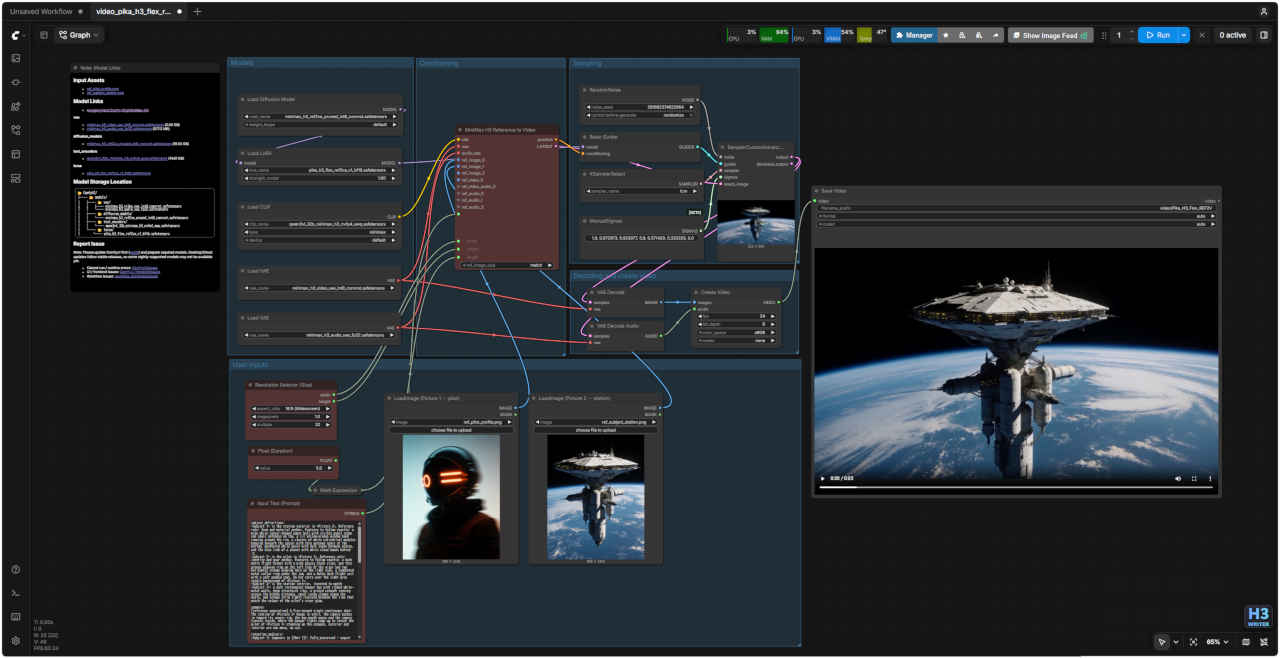
| ⑤ Pika H3 Flex: Reference to Video | video_pika_h3_r2v.json | |
| 生成動画 864x480 | |
| Pika H3 Flex: Text to Video ワークフロー | Pika H3 Flex: Text to Video SubGraph |
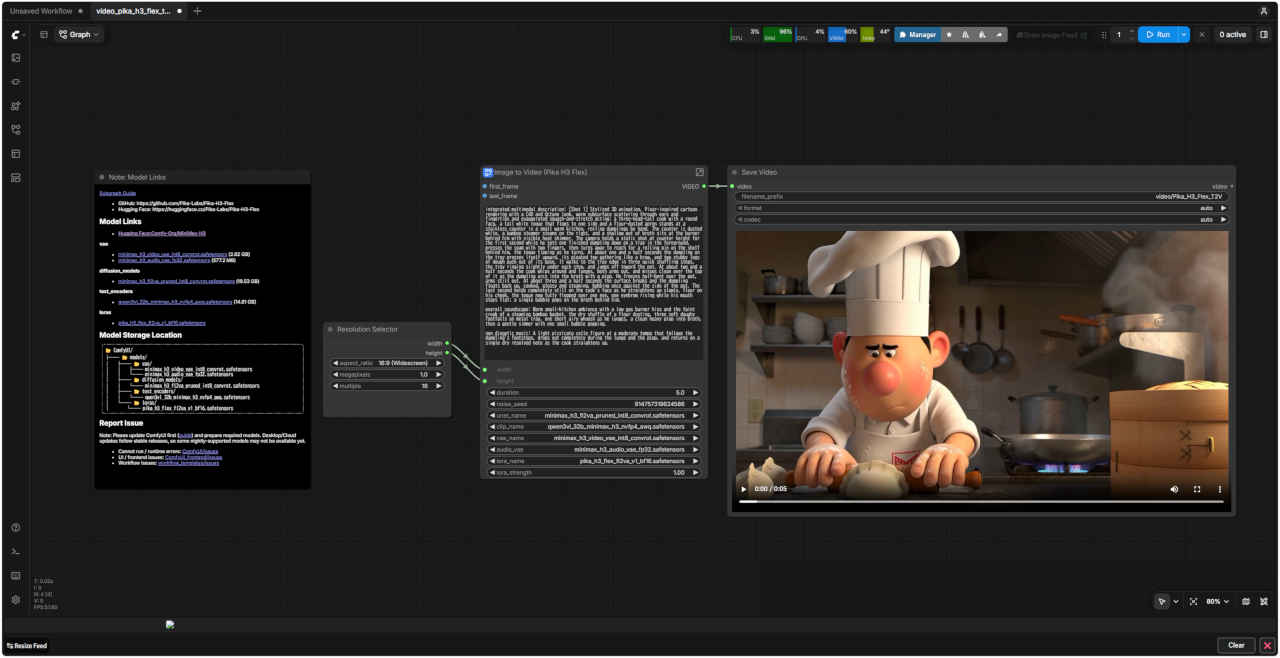 | 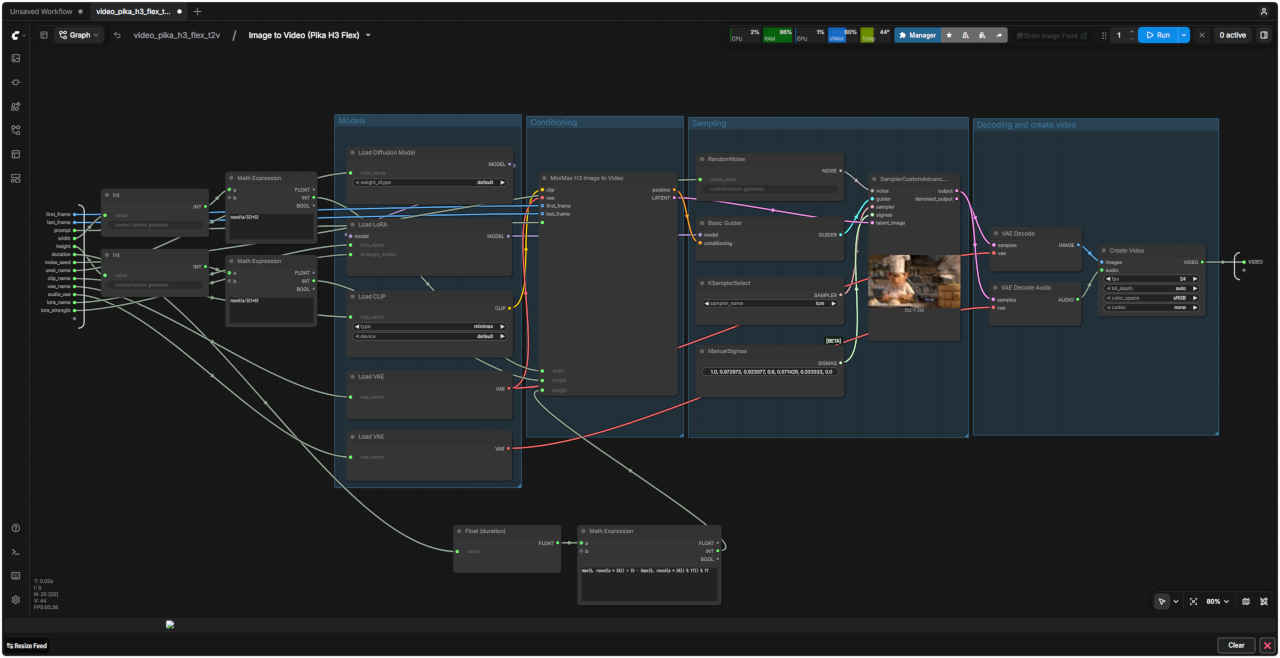 |
| 「MiniMax/」video_pika_h3_flex_t2v.json | |
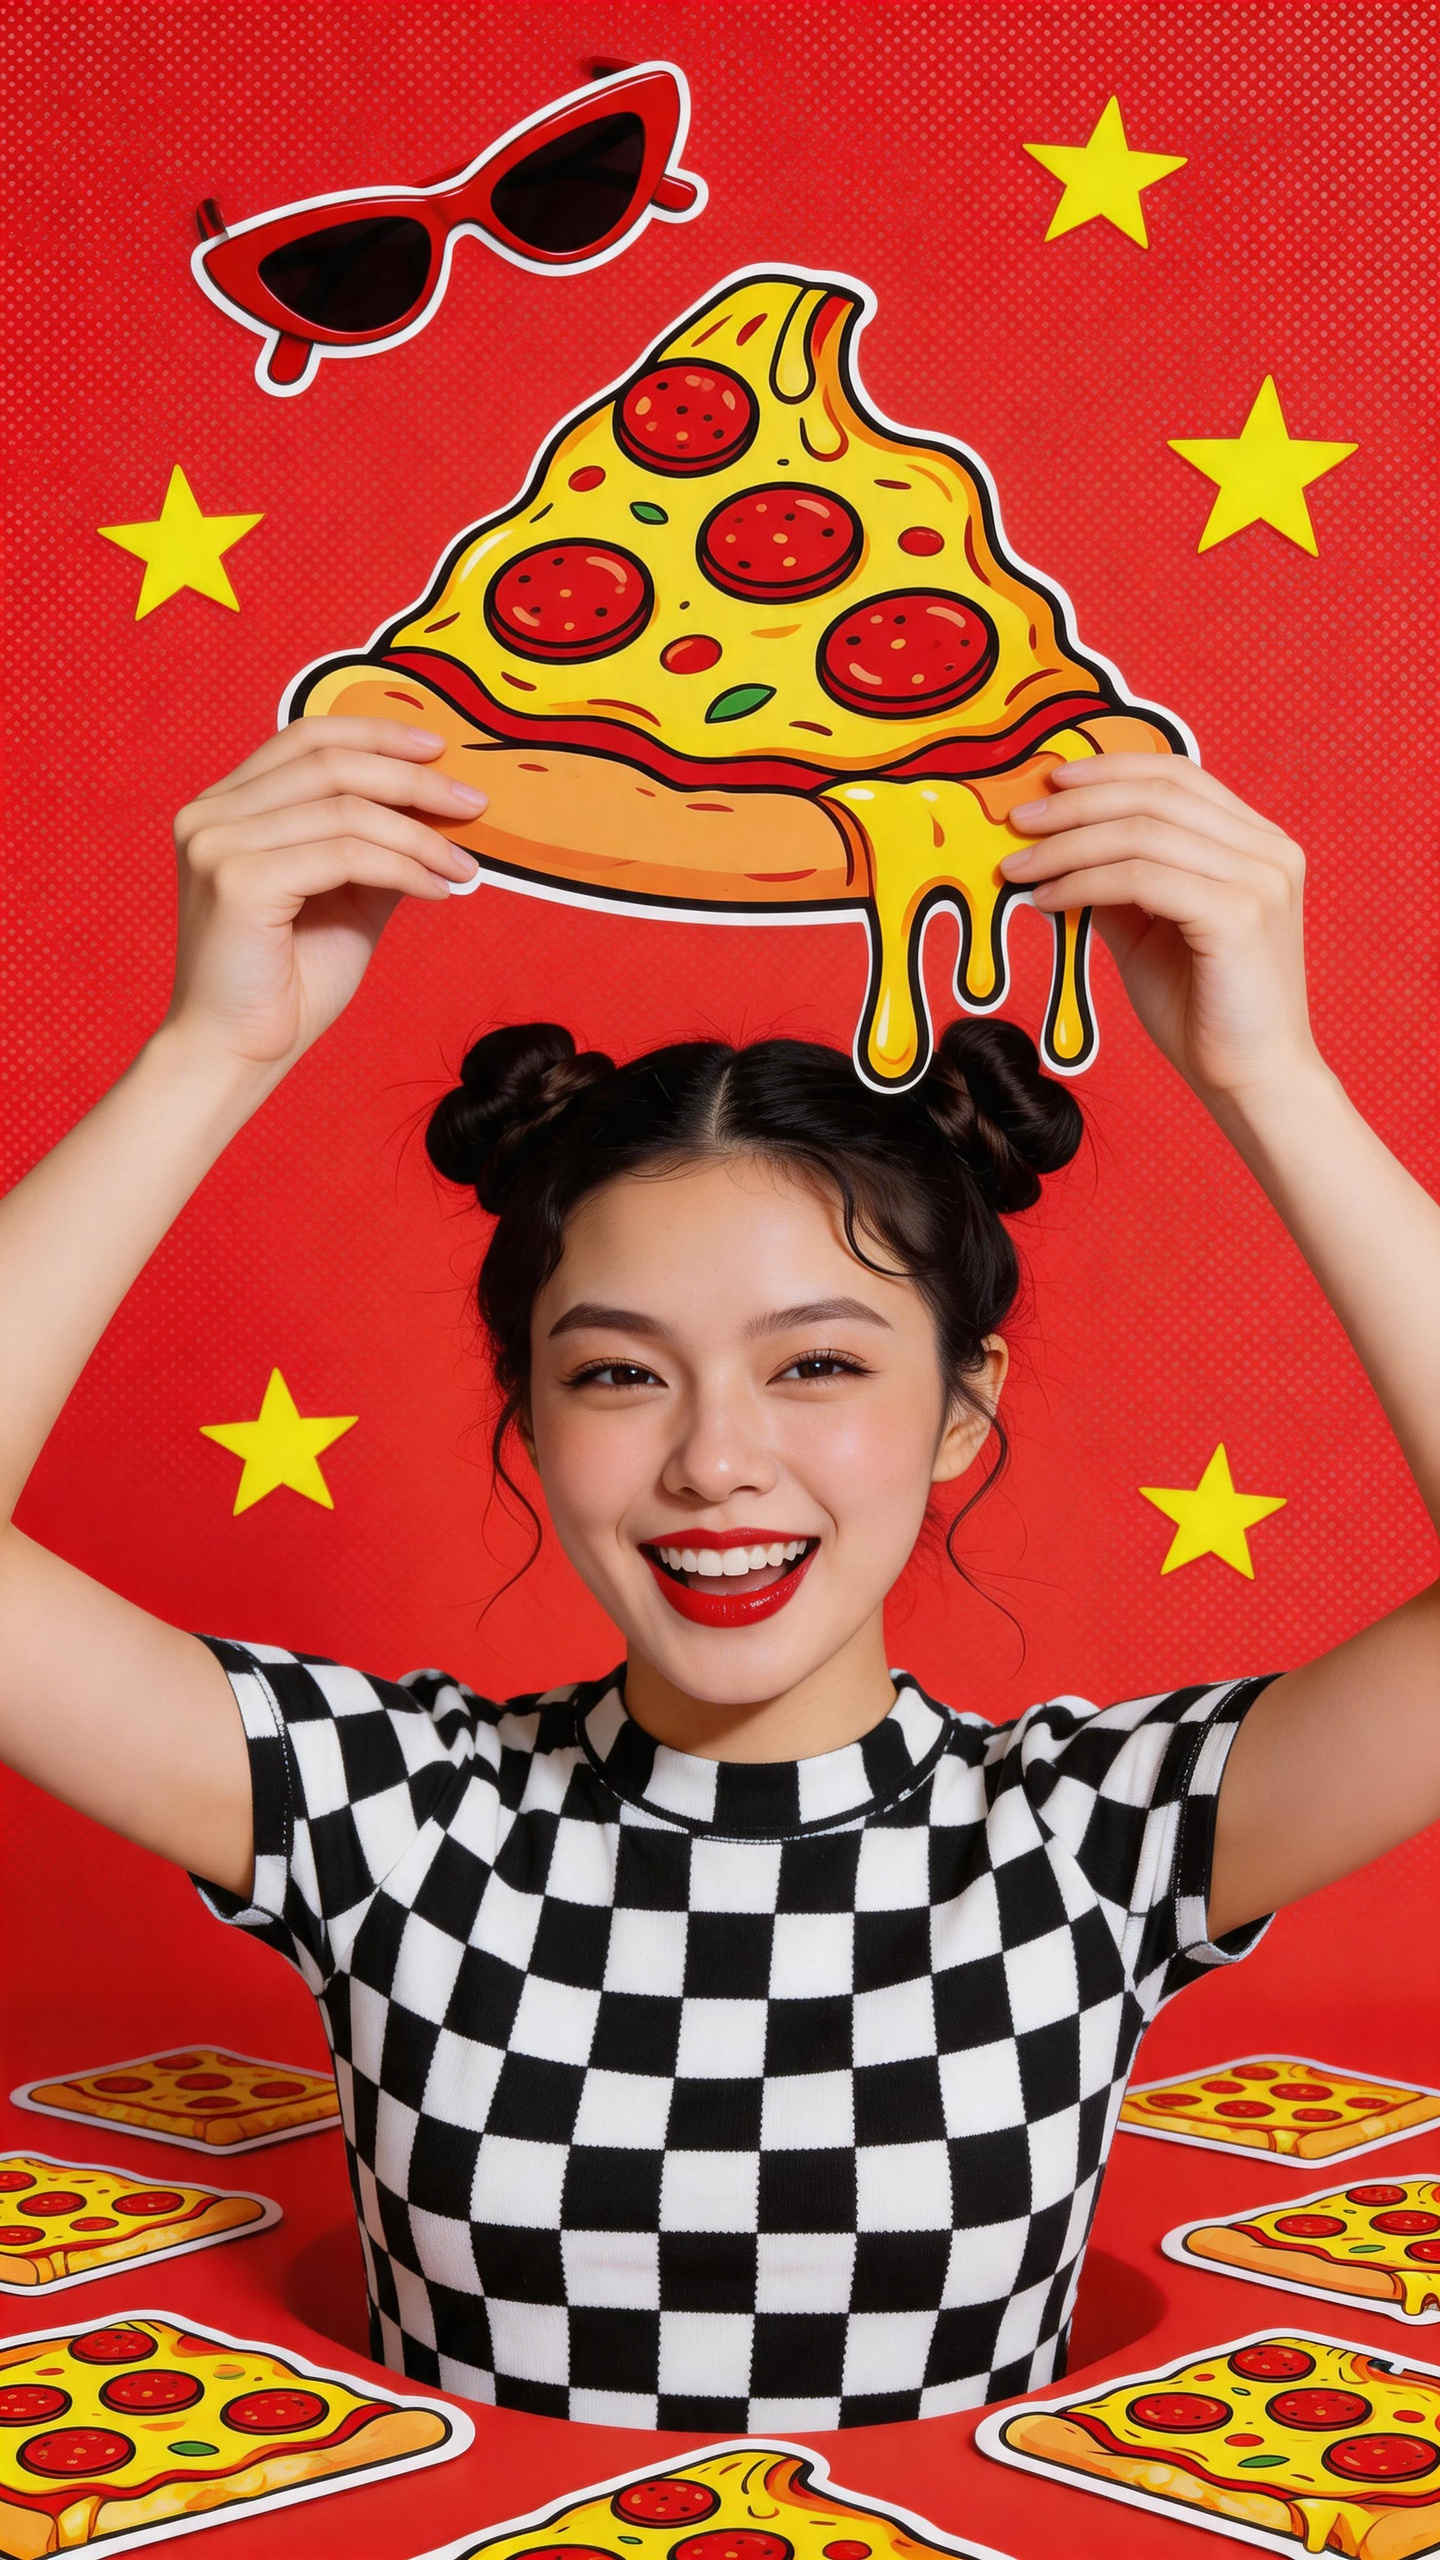
| 入力静止画像① | 入力静止画像② | 生成動画 768x1344 |
 | 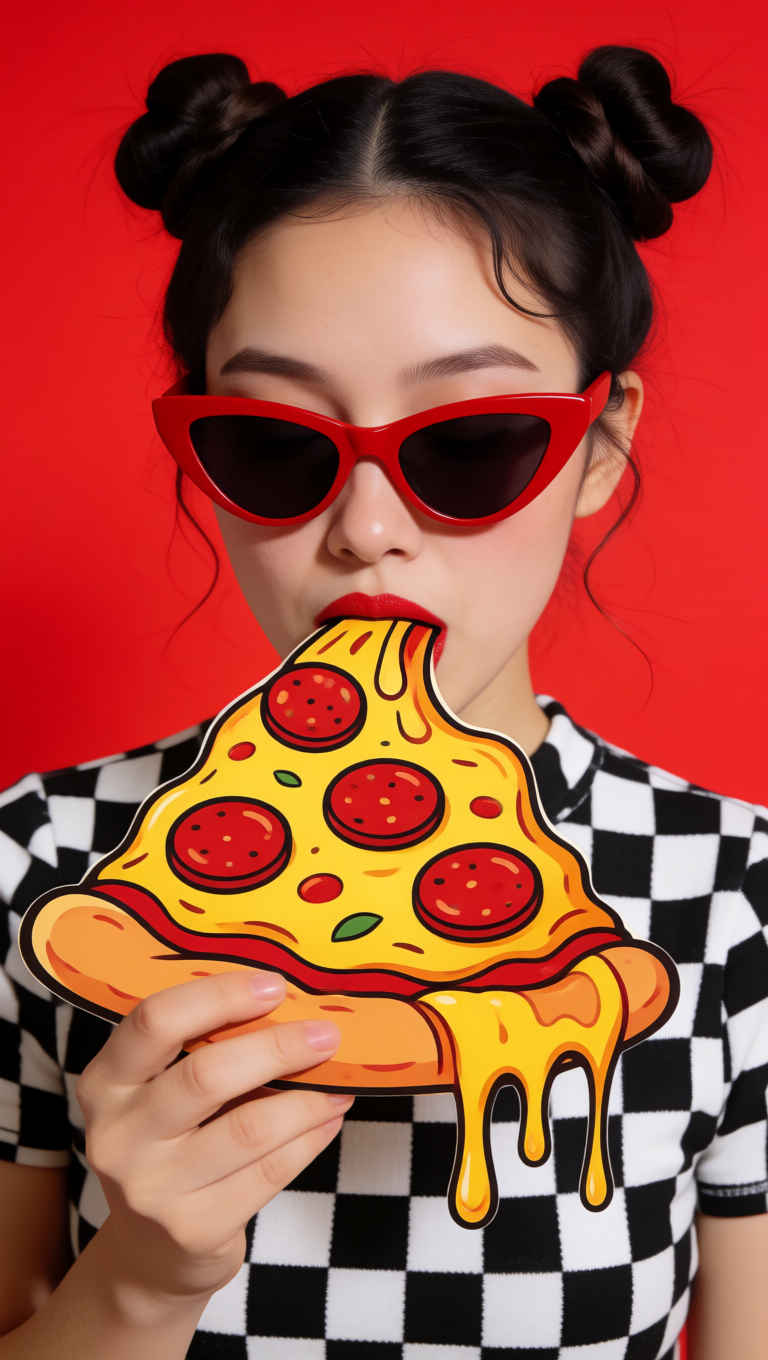 |
| 参照用静止画像 ① | 参照用静止画像 ② |
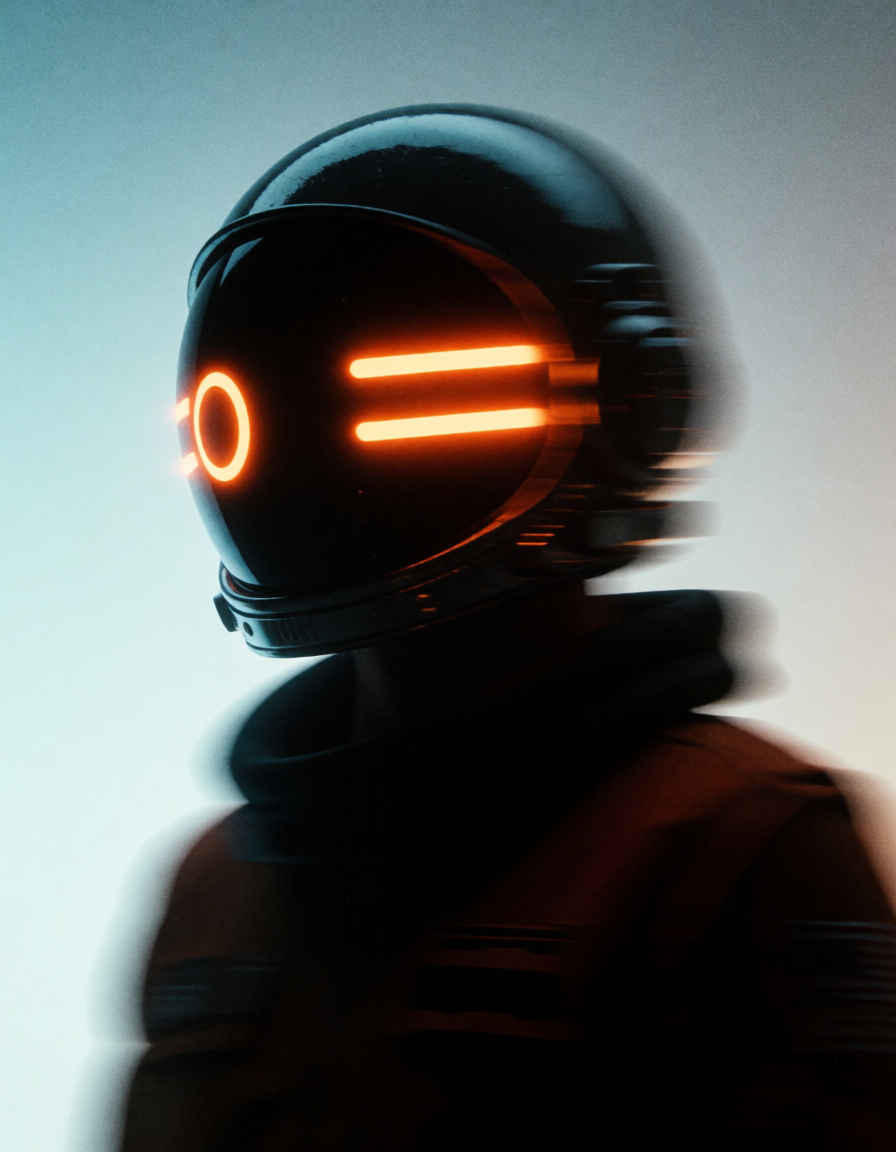 ref_pilot_profile.png | 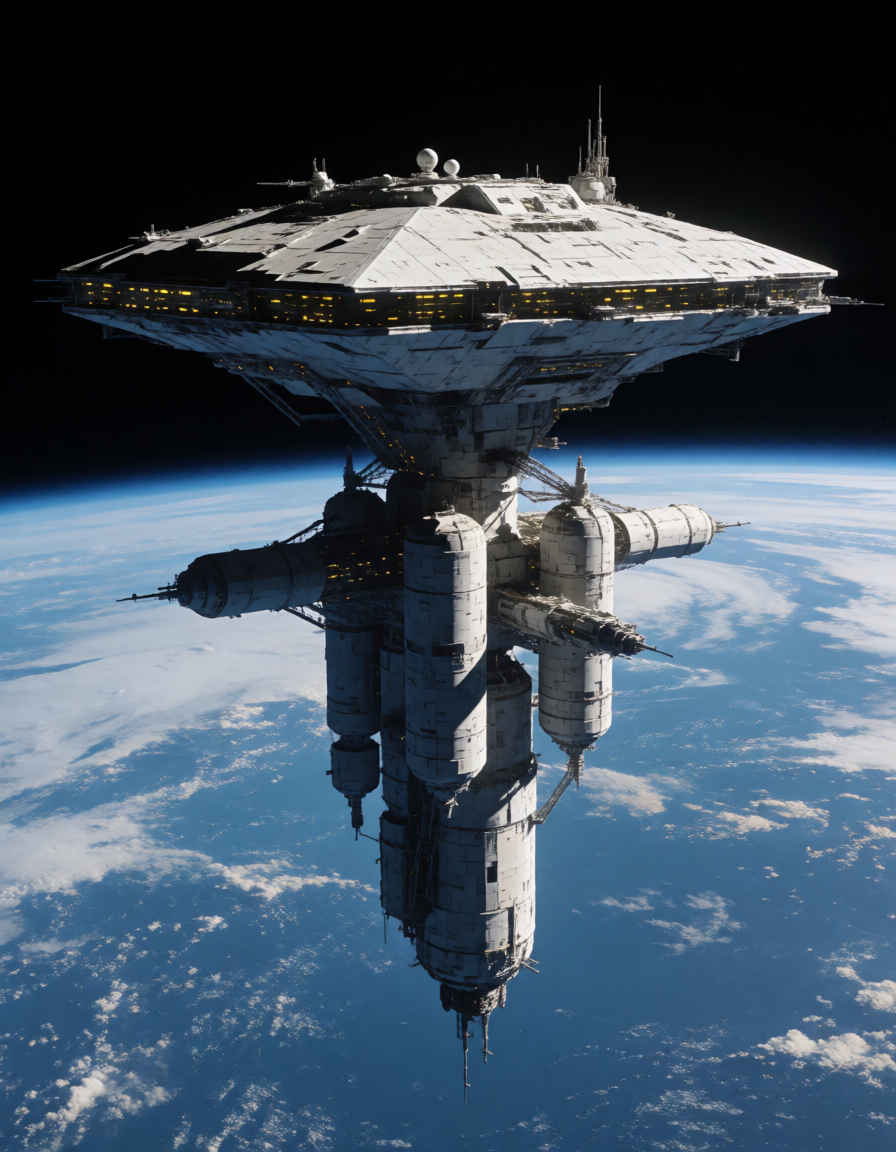 ref_subject_station.png |
| ComfyUI オフィシャルサイトで公開されているテンプレートのシード値を固定して再現性を確保し動かしながら整理する |
| プロンプト |
|
integrated_multimodal_description: [Shot 1] Live-action, cinematic, a static medium shot frames a Japanese female model walking straight toward the camera in a high-end fashion studio. The camera remains fixed as she maintains a steady pace throughout the 5-second sequence without any cuts or camera movement. overall_soundscape: The studio is quiet with only the soft, controlled footsteps of the model on polished flooring and the subtle hum of professional lighting equipment. non_diegetic_music: N/A |
| 統合マルチモーダル記述:[ショット1] 実写、映画的。高級ファッションスタジオにて、日本人女性モデルがカメラに向かって真っ直ぐに歩いてくる様子を、固定されたミディアムショットで捉えている。カメラは動かず、5秒間のシーケンス全体を通して、カットやカメラの動きは一切ない。 全体的な音響環境:スタジオ内は静寂に包まれており、聞こえるのは、磨き上げられた床を歩くモデルの控えめで安定した足音と、プロ用照明機材が発する微かな駆動音のみである。 非劇伴音楽:なし |
| プロンプト | 入力画像 first_frame | |
|
integrated_multimodal_description: [Shot 1] A young Japanese woman standing facing the camera in soft, natural outdoor light. Please maintain the facial features, hairstyle, wearing a simple black sleeveless top with a soft V-neckline, physique, background, and composition shown in <Picture 1>. She blinks naturally, tilts her head slightly, and wears a gentle smile. A few strands of hair sway slightly in time with her breathing. The camera slowly and smoothly zooms in (pushes in) while remaining focused on her face. overall_soundscape: Quiet outdoor ambience with subtle clothing and hair movement sounds. | 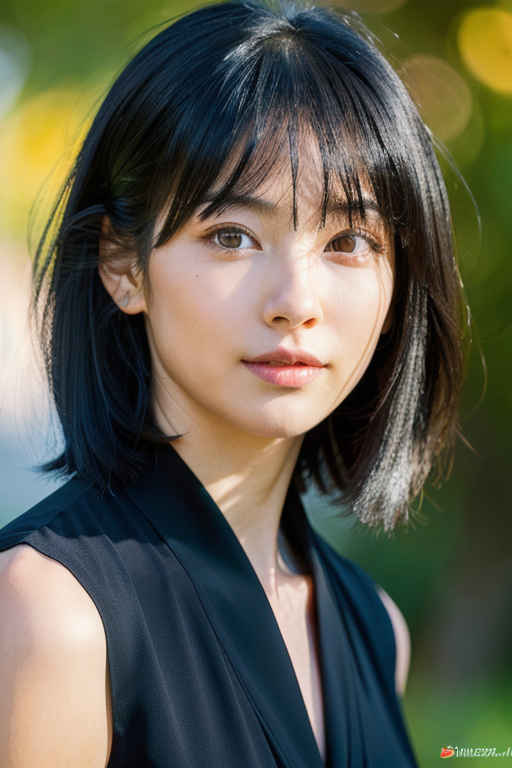 | |
| 統合マルチモーダル記述: [ショット 1] 屋外の柔らかな自然光の中、カメラに向かって立つ若い日本人女性。顔立ち、髪型、シンプルな黒のノースリーブトップス(緩やかなVネック)、体型、背景、そして構図は、<画像 1>の通りに維持すること。彼女は自然にまばたきをし、少し首を傾げ、穏やかな笑みを浮かべている。呼吸に合わせて、数本の髪の毛がわずかに揺れる。カメラは彼女の顔に焦点を合わせたまま、ゆっくりと滑らかにズームイン(接近)していく。 全体的な音響環境: 静かな屋外の環境音。衣服や髪が動くかすかな音も含まれる。 | ||
| 5632 FL2VA ワークフロー | 生成動画 512x768 |
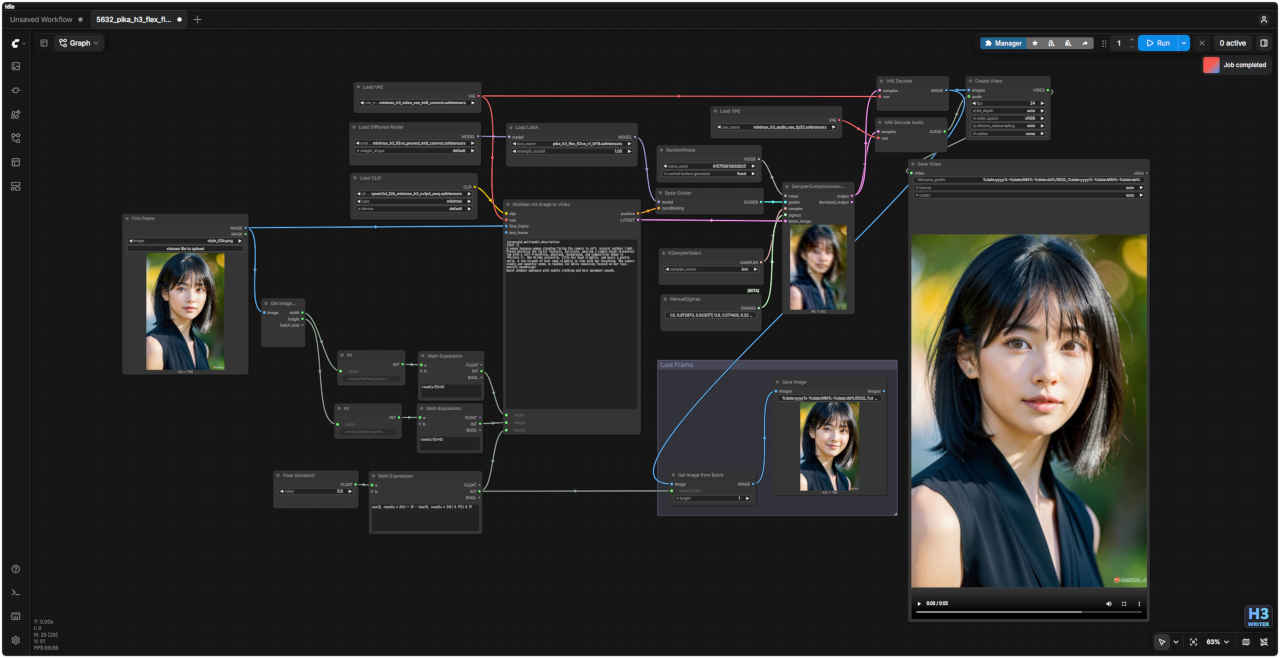 「MiniMax/」5632_pika_h3_flex_fl2va.json |
| プロンプト | 入力画像 ① first_frame | 入力画像 ② last_frame |
|
How the reference pictures align with the target video ? Picture 1 (from Shot 1) aligns with the 0.00-second mark of the target video; Picture 2 (from Shot 1) aligns with the 5.00-second mark of the target video. integrated_multimodal_description: [Shot 1] At the 0.00-second mark, <Image 1> serves as the primary visual reference. The woman is smiling gently at the camera. Her appearance, shoulder-length straight black hair and bangs, wearing a simple black sleeveless top with a soft V-neckline, standing outdoors in natural daylight. While maintaining eye contact with the camera, she naturally adjusts her posture and places both hands on her hips. The camera slowly pulls back (zooms out) to reveal her full standing figure. At the 5.00-second mark, the framing, posture, hand placement, attire, and composition smoothly transition and settle into the state shown in <Image 2>. This change occurs within a single continuous shot, without any cuts or abrupt switches. Overall audio environment: Quiet outdoor ambient sounds. | | 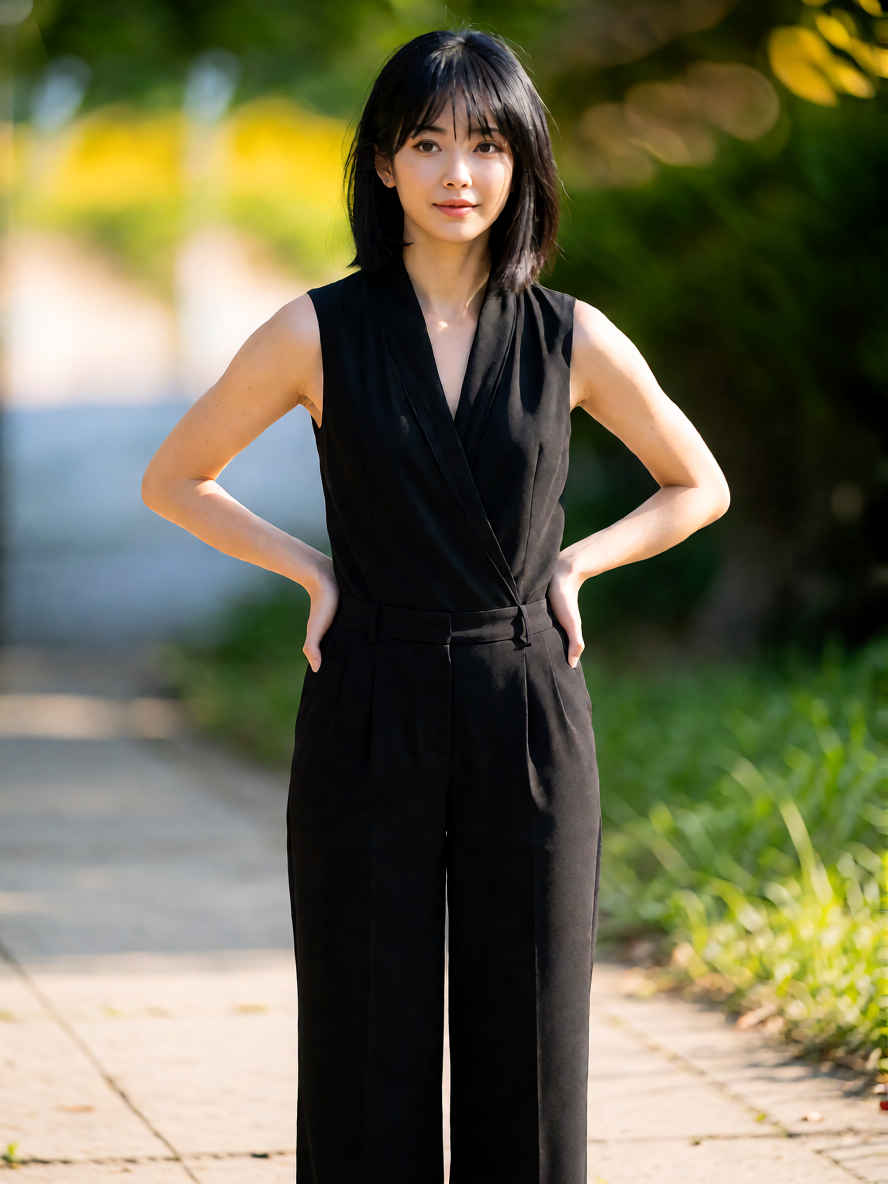 |
| 参照画像と対象動画の対応関係は以下の通りです。画像1(ショット1より)は対象動画の0.00秒時点に対応し、画像2(ショット1より)は対象動画の5.00秒時点に対応しています。 統合マルチモーダル記述: [ショット1] 0.00秒時点では、<画像1>が主要な視覚的参照となります。女性がカメラに向かって穏やかに微笑んでいます。彼女は肩までの長さのストレートな黒髪に前髪を下ろしたスタイルで、緩やかなVネックのシンプルな黒いノースリーブトップスを着用しており、自然光が差し込む屋外に立っています。 カメラと視線を合わせたまま、彼女は自然な動作で姿勢を整え、両手を腰に置きます。カメラはゆっくりと後退(ズームアウト)し、彼女の全身を捉える構図へと変化します。 5.00秒時点では、フレーミング、姿勢、手の位置、服装、そして構図が滑らかに変化し、<画像2>に示す状態へと落ち着きます。この変化は、カットや急な切り替えを伴わない、一つの連続したショットの中で行われます。 全体的な音響環境: 静かな屋外の環境音。 |
| 5633 FL2VA ワークフロー | 生成動画 512x768 |
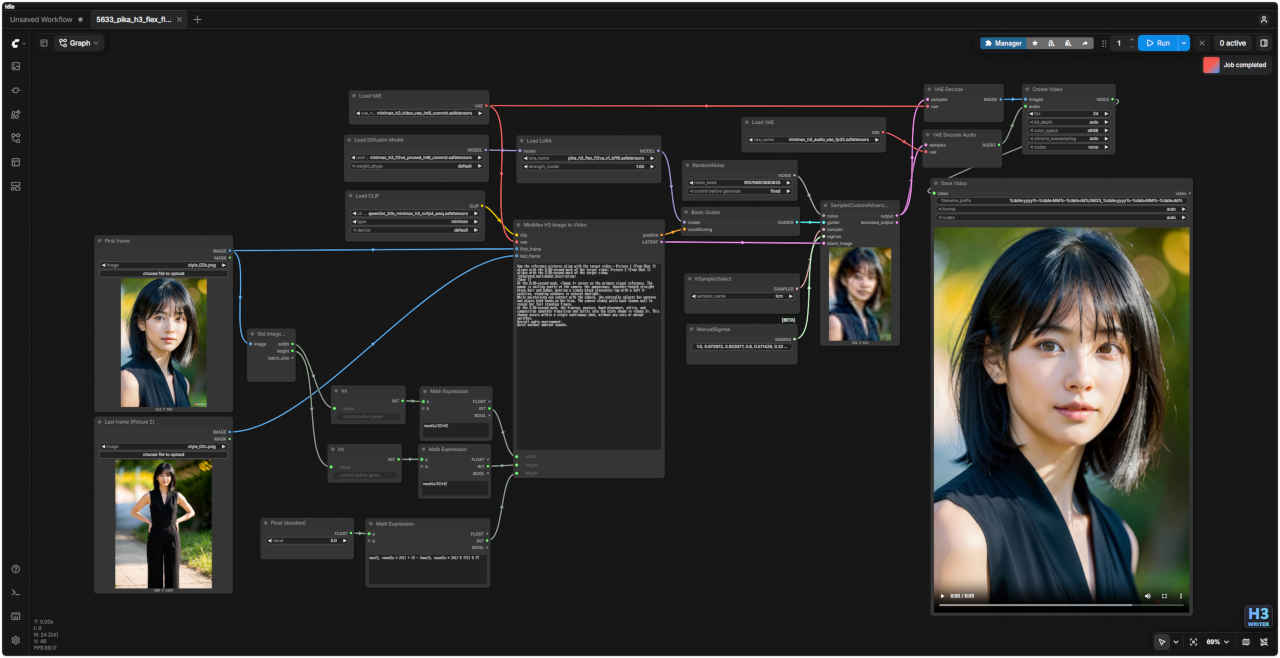 「MiniMax/」5633_pika_h3_flex_fl2va.json |
| 参照用静止画像 ① | 参照用静止画像 ② |
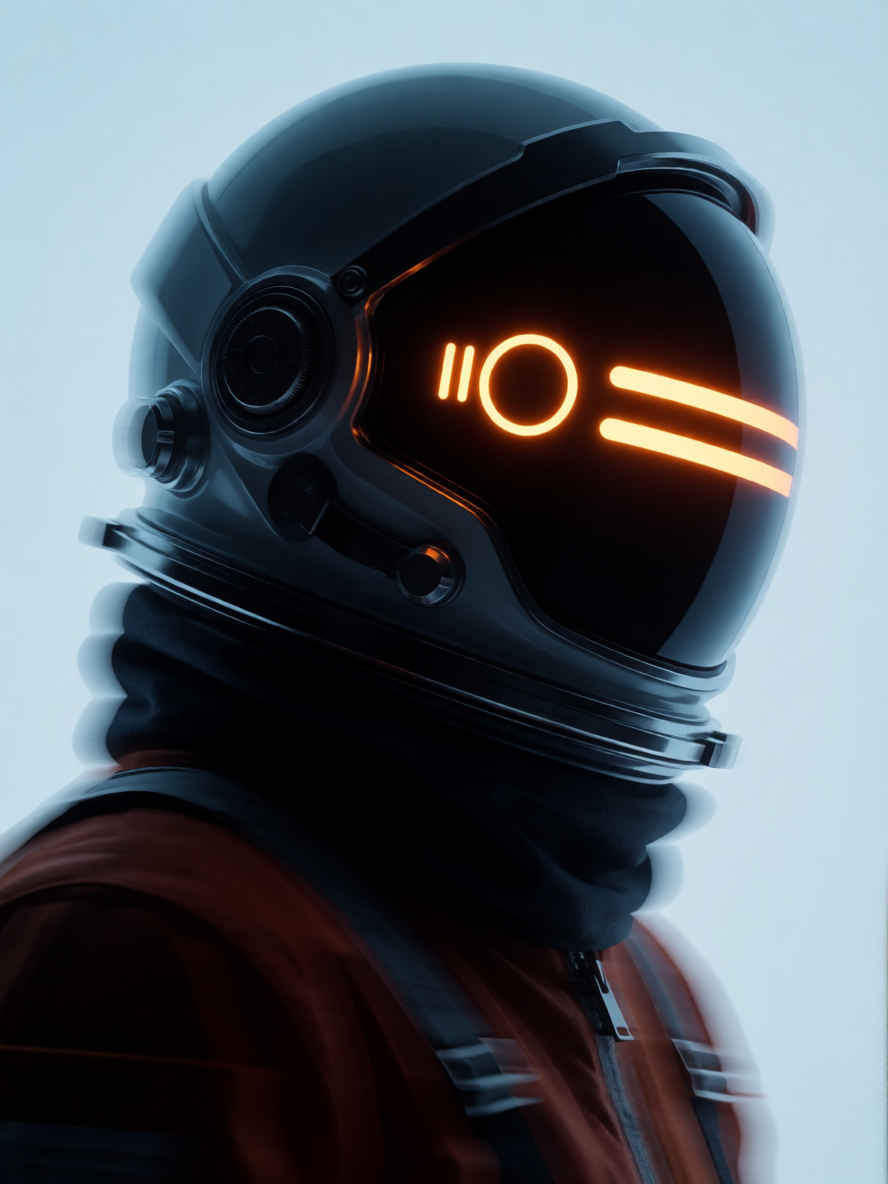 | ref_subject_station.png |
| 5634 Reference to Video ワークフロー | 生成動画 1344x768 |
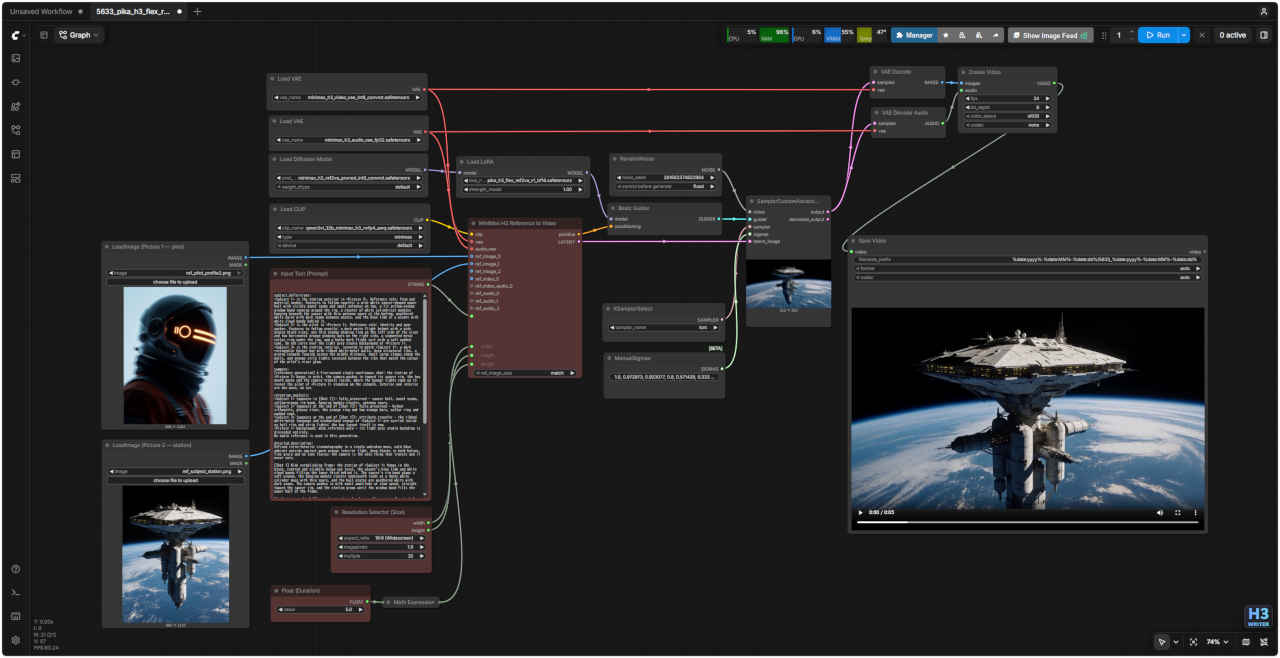 「MiniMax/」5634_pika_h3_flex_ref2va.json |